V8引擎技术简介
前言
2009年,Google启动了浏览器项目,V8引擎诞生的使命就是性能的极致,Google觉得这这种架构生成字节码会浪费时间,决定一步到位直接采用机器码。
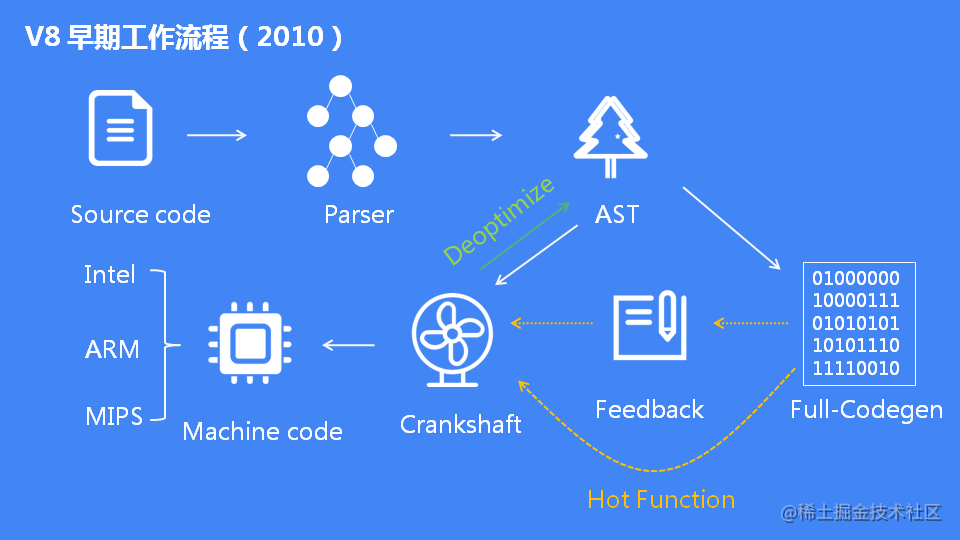
早期V8引擎包含了Full-Codegen和 Crankshaft(曲轴) 两个编译器,即:JS源代码会被V8引擎进行两次解析,第一次使用Full-Codegen进行快速编译,而第二次使用Crankshaft进行深度优化编译,其基本处理流程为:
- 将js源代码转化成AST(抽象语法树)。
- 通过
Full-Codegen引擎编译AST变成基准的机器码,然后直接执行这些未经优化的二进制文件。 - 在执行机器码的过程中,通过内置的
Profiler分析器筛选出热点函数,将标记的代码通过Crankshaft引擎进行优化编译生成优化的机器码。 - 再次运行到这个Javascript函数时,直接使用缓存中优化的机器码。
通过取消字节码环节,V8引擎的运行速度有了明显的提示,但随着Web网页的复杂性,尤其是在智能终端上的应用普及,这种架构也暴露了不少严重的缺陷:
- 内存占用过高:Full-Codegen生成机器码会占用大量内存,一个1M左右的JS源码文件通过编译生成的机器码通常达到10M+,而早期手机内存普遍有限,过度占用会导致性能大大降低
- 启动速度较慢:Full-Codegen编译直接生成机器码,需要较长的编译时间,导致应用启动的速度受到较大影响
- 跨平台支持难:Crankshaft直接生成机器码,需要自行适配不同的CPU架构,难以适应手机终端的复杂性
上述架构问题的集中体现,就是2016年Facebook报告的Chrome代码缓存失效Bug。
当时的Chrome浏览器重复加载Facebook主页,第一次加载时长165ms,但重复加载时发现时长几乎没有变化,说明真正耗时高的js代码并没有被缓存和优化。
导致该Bug的原因:为缓解二进制代码占用内存空间大的矛盾,V8采取了惰性编译的优化原则(即只对最外层的代码进行优化编译),而Facebook首页采用的IIFE(立即调用函数表达式,类似于闭包函数)代码封装方式,导致浏览器并未对IIFE函数的内部关键代码进行优化。
一、V8引擎的技术架构 - 字节码的回归
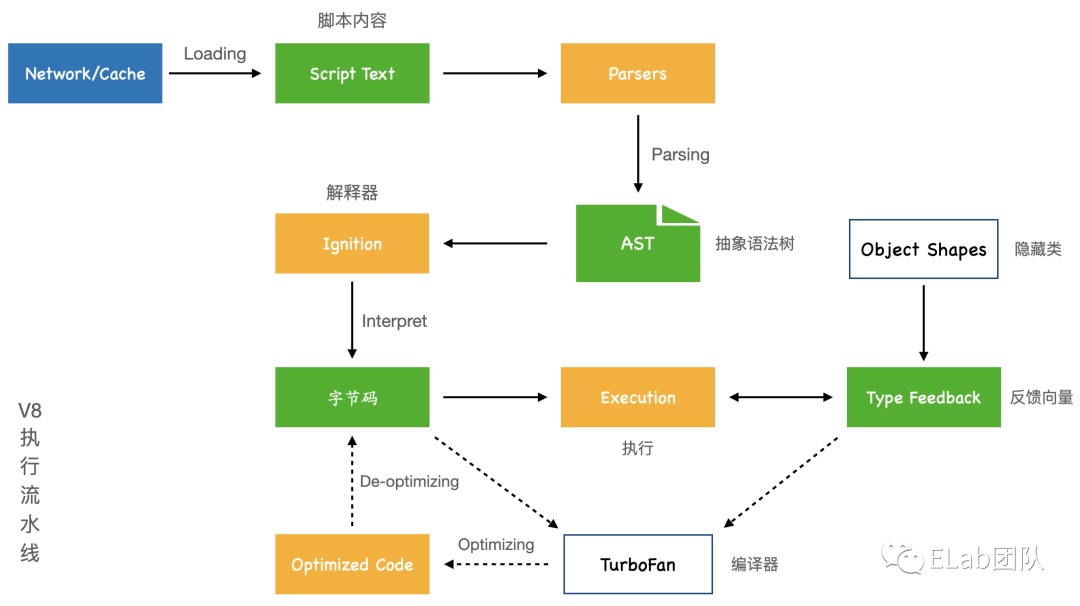
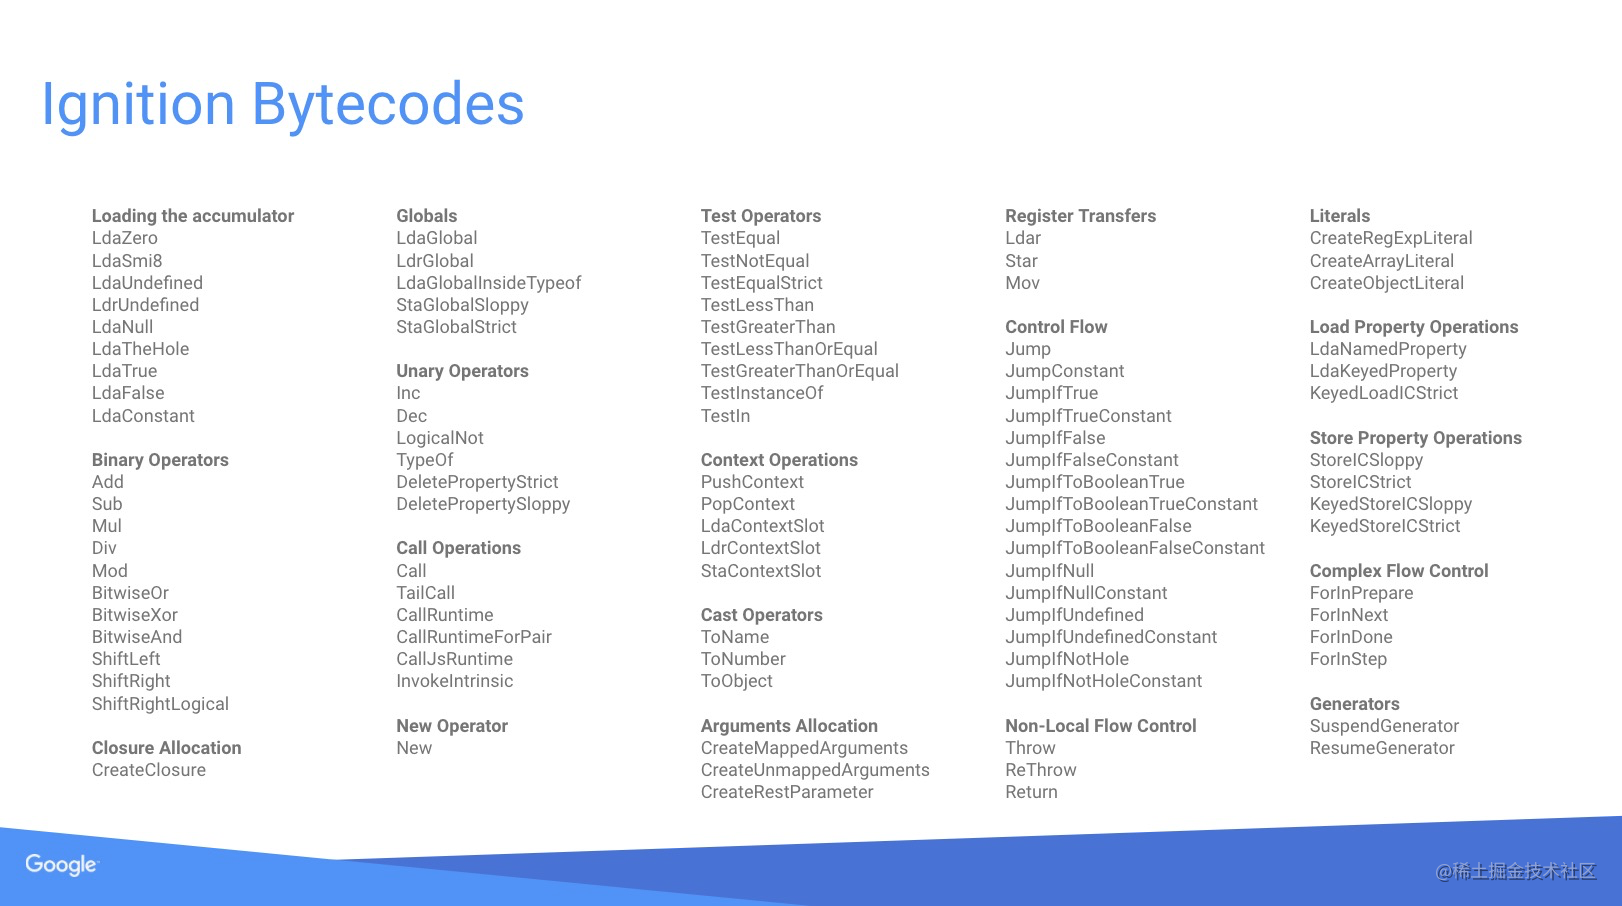
2017年,Google发布了V8 5.9版本,完全废弃并移除了full-codegen和 Crankshaft,新增了 Ignition(点火器)字节码解释器和Turbofan(涡轮风扇)优化编译器,标志着字节码技术的全面回归。
Ignition:本质上就是一个类似于Java中的JVM虚拟机,负责将AST编译成字节码,并逐句进行解释形成二进制代码并执行。Turbofan:在解释执行的过程中,Ignition标记重复执行的热点代码,将相应的字节码提交给Turbofan,编译生成优化的机器码并缓存,今后再次运行到这个函数时便只执行机器码而非字节码
也就是说,JS脚本有三种不同的启动方式:
Cold load冷启动: 首次加载脚本文件时,Ignition编译生成字节码文件并解释执行,没有任何数据缓存Warm load暖启动:如果V8发现第二次使用了相同的脚本文件,将提交给Turbofan编译生成机器码文件,并与脚本文件一起加载到磁盘缓存中Hot load热启动: 如果第三次加载相同的脚本文件,V8可以从磁盘缓存中载入脚本,并直接执行对应的机器码文件
js文件加载的过程并不是由V8负责的,它可能来自于网络请求、本地的cache或者是也可以是来自service worker,浏览器的js加载过程是V8引擎的前置步骤。
通过重新引入字节码技术,原有V8引擎存在的问题有了显著改善,体现在:
- 首次启动时只需要编译出字节码,然后逐句执行字节码,编译出字节码的速度可远远快于编译出二进制代码的速度。
- 字节码的数据量远远低于机器码,因此内存和磁盘的空间占用大大减少。
Turbofan直接利用Ignition已经生成的字节码进行编译优化,无需源代码的二次解析,代码复杂度和处理效率都有提升- 通过虚拟机和字节码技术适配不同CPU架构体系,引擎代码的复杂度大大降低。
二、JavaScriptCore的技术架构
JavaScriptCore(缩写为 JSC),是Apple 的 JavaScript 引擎,被用于 Safari 和 React Native 两个项目中。
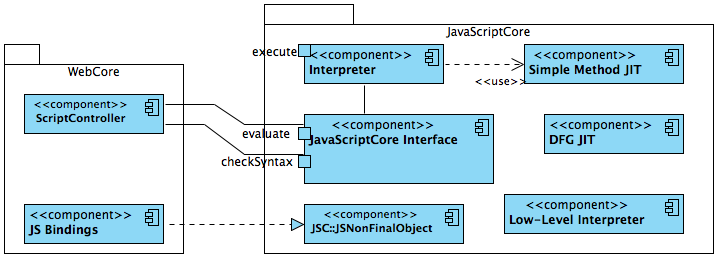
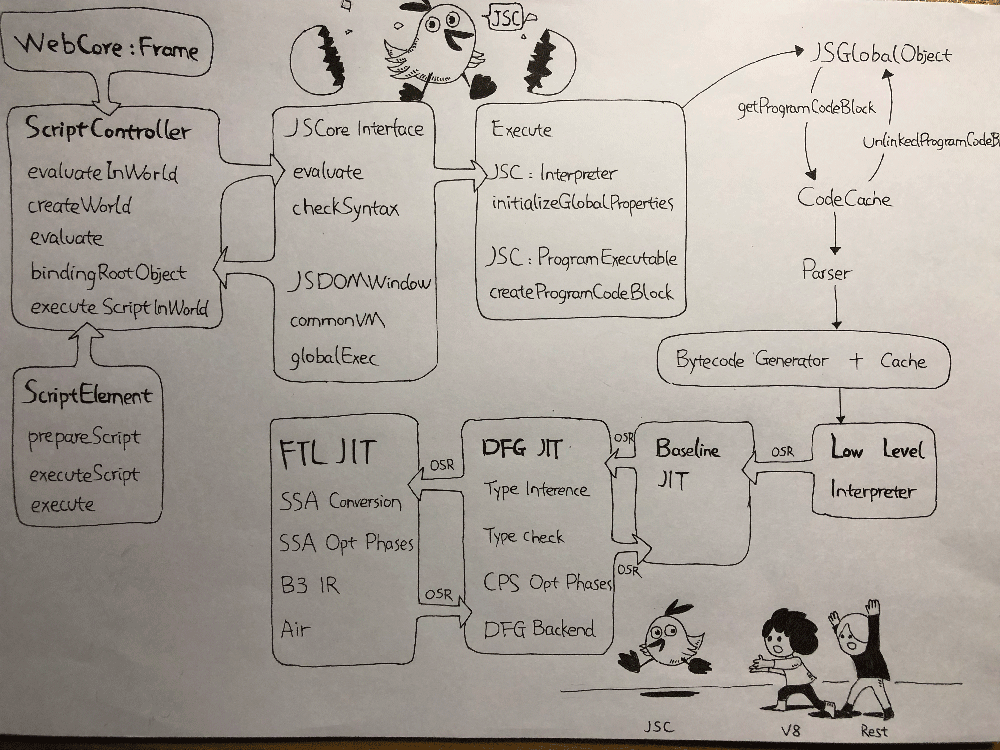
JavaScriptCore有四种不同的代码执行方式:
1. LLInt(Low Level Interpreter)- 解释器模式
LLInt是用跨平台的汇编语言实现的,负责逐条解释执行JSC虚机指令,JS代码的执行总是从LLInt模式开始的。
执行 Parser 生成的 Byte code。代码在 llint/ 里,使用的汇编语言代码在 offlineasm/ 里,可以编译为 x86 和 ARMv7 的汇编和 C 代码。LLInt 希望达成除了词法和语法分析外零启动消耗,同时遵守用 JIT 在调用,堆栈和起存器的约定。
2. Baseline - 基本的实时编译模式
Baseline只是做了简单的“机器码化”,减小了解释器按指令dispatch的开销,代码(指令序列)本身并未做任何优化。
在函数调用了6次,或者某段代码循环了大于100次会被触发。BaseLine 的代码在 jit/ 里。BaseLine JIT 还对几乎所有堆的访问执行了复杂的多态内联高速缓存(Polymorphic inline caches)。
3. DFG(Data Flow Graph):低延迟优化的实时编译模式
如果Baseline性能不足,就用DFG生成更优化的机器码来执行。
在函数被调用了60次或者代码循环了1000次会触发。DFG会把字节码转成CPS形式(Continuation-Passing Style)后编译成机器码,目的是减少后续生成代码时需添加的类型检查逻辑。
编译时计算常量数据,并将它传播到相关代码中,达到整体简化代码的目的。
启用了多种常规的编译优化,包括:寄存器分配、控制流图简化、公共子表达式消除、无用代码消除、稀疏有条件的常量传播等。DFG代码在 dfg/ 里。定期评估优化效果,如果更差性能,将回退到Baseline,看情况再次决定是否调用DFG。
4. FTL(Faster Than Light):高吞吐量优化的实时编译模式
FTL主要是配合后端进行优化,之前是使用的LLVM后端,后来为了减少内存开销,对LLVM进行了裁剪并改名为B3。
复用了DFG的大部分流程,将原DFG流程中的DFG后端替换为新的FTL流程,重点优化如下内容:CPS转SSA、SSA转LLVM IR、LLVM IR的编译优化、IR转机器码等。
三、其它浏览器的技术架构
SpiderMonkey,是在 Firefox 和 SpiderNode 中使用的 Mozilla 的 JavaScript 引擎,包含了两个优化编译器。
`
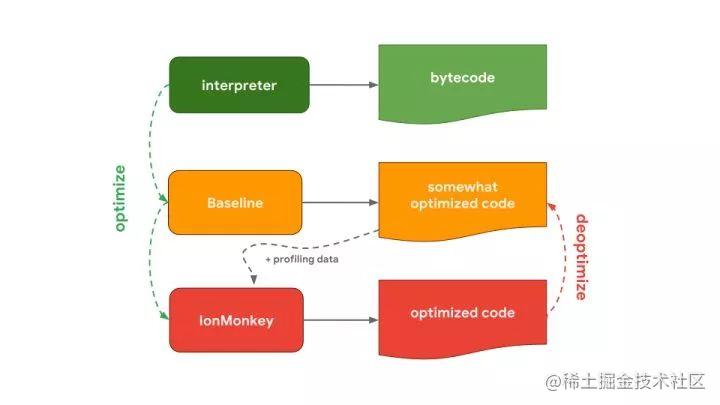
- 解释器将代码解释给
Baseline编译器,该编译器可以生成部分优化的代码。 - 结合运行代码时收集的分析数据,
IonMonkey编译器可以生成高度优化的代码。 - 如果尝试优化失败,IonMonkey 将回退到 Baseline 阶段的代码。
Chakra,是用于 Edge 和 Node-ChakraCore 两个项目的微软 JavaScript 引擎,与SpiderMonkey非常类似,也有类似两个优化编译器的设置。
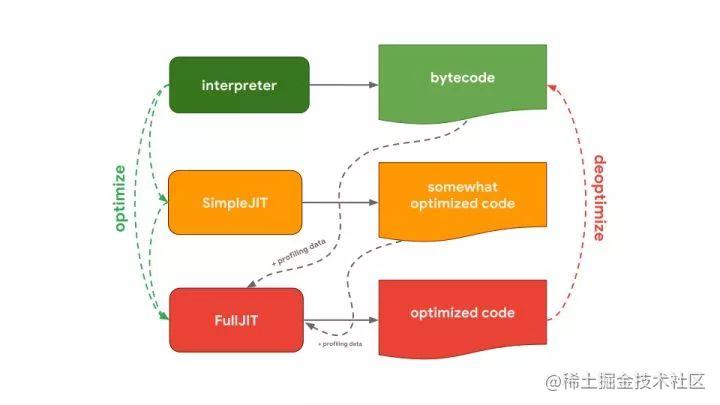
- 解释器将字节码提交给
SimpleJIT,生成部分优化的机器码 - 结合解释器的运行分析数据,
FullJIT生成深度优化的机器吗
四、基本结论
1. 黄金组合 = 字节码解释器 + JIT 编译器
解释器技术和编译器技术的历史悠久,各有所长,通过多年的发展正在逐步走向融合,已经成为现代主流浏览器的普遍共识。
以Ignition + TurboFan为例,
- 首先,解释器完成字节码编译并快速启动应用,同时收集执行信息并记录热点代码
- 后台的JIT编译器把字节码编译成高效机器码,并缓存到磁盘文件
- 后续启动时,只执行优化后的高效机器码,而不再解释执行字节码
2. 为什么需要多个不同的编译器?
这完全是一些折衷的取舍。一方面,解释器可以快速生成字节码,但字节码的执行速度(不是启动速度)通常不够快。另一方面,优化编译器处理需要更长的时间,但最终会生成更高效的机器码。到底是快速获取可执行的代码(解释器),还是花费更多时间但最终以最佳性能运行代码(优化编译器),这其中包含一个平衡点。
因此,现代JS引擎通常选择同时提供几个不同特性的优化编译器,以更高的复杂性为代价来对这些折衷点进行更细粒度的控制。
3. 影响编译器性能的关键技术
- 词法分析 Scanner 、语法分析 Parser 和 抽象语法树 AST
- 字节码设计,基于栈或者基于寄存器的虚拟机
- 内联缓存(Inline Cache)
- 内存管理和垃圾回收策略(Garbage Collection)
- 多线程管理和消息队列
本文暂不展开,先点个题备着,未来还将继续研究!
参考文献
官方资料
技术研究
- V8引擎详解系列 - 阿里巴巴暮桥
- Google V8引擎浅析 - 字节跳动ELab团队
- 深入理解JavaScript的V8引擎
- 深入了解 JavaScript 引擎精华
- 初识 JavaScriptCore JIT