Apple File System的软件加密分析

AFPS(Apple File System)是 Apple 平台上使用的默认文件格式。APFS 继承自 HFS+,因此其设计的某些方面有意遵循 HFS+ 以便于历史数据的迁移。

Apple File System 支持对容器、卷和文件使用的数据结构进行加密。当一个卷被加密时,它的文件系统树和该卷中的文件内容都被加密。根据设备的能力,苹果文件系统使用硬件或软件加密:

  • 硬件加密:用于支持硬件加密的设备的内部存储,包括macOS(带T2安全芯片)和iOS设备。
    当使用硬件加密时,只有内核(安全隔区)可以与内部存储交互。
    既支持 FDE 单密钥模式,也支持 FBE 多密钥模式。
  • 软件加密:用于外部存储(U盘或外接硬盘),以及不支持硬件加密的设备(Intel CPU的Macbook)上的内部存储。
    当使用软件加密时,仅支持 FDE 单密钥模式。

大多数应用程序可以使用 Apple 提供的高级接口与文件系统交互,无需自行处理加密和解密,但为了支持跨操作系统的应用(如磁盘备份恢复、Linux系统读取APFS磁盘数据),Apple 提供了Apple File System Reference,公开了技术实现细节,开发者可以自行实现加密和解密处理。

一、总体架构

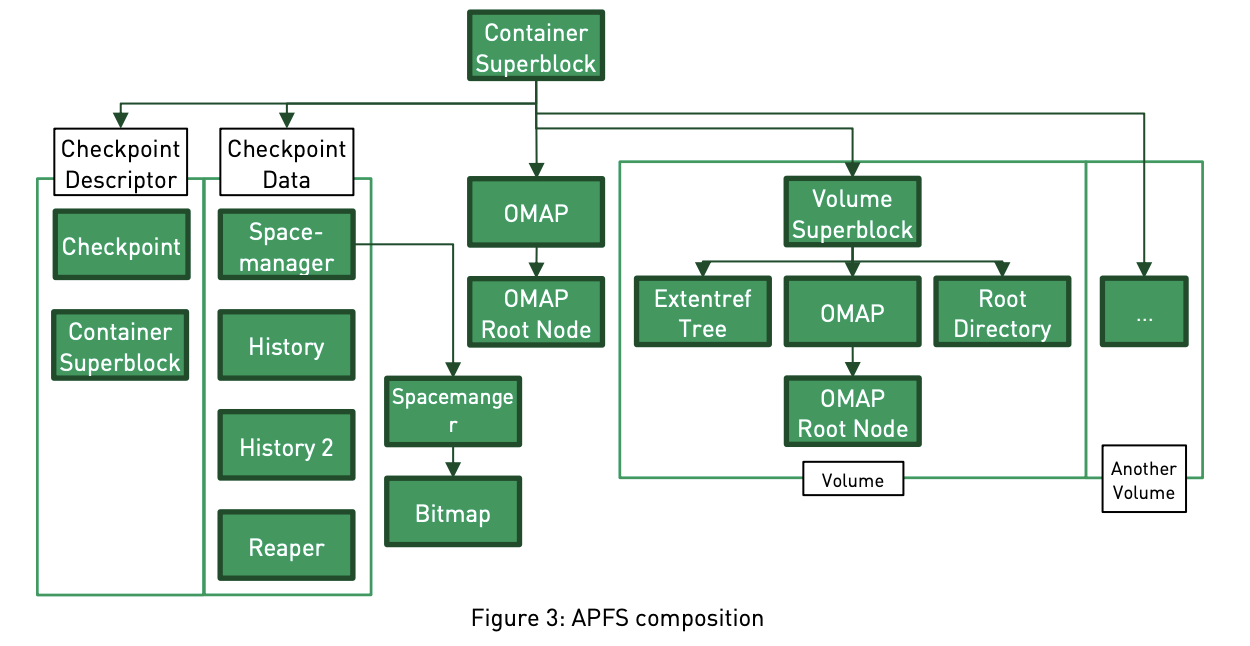
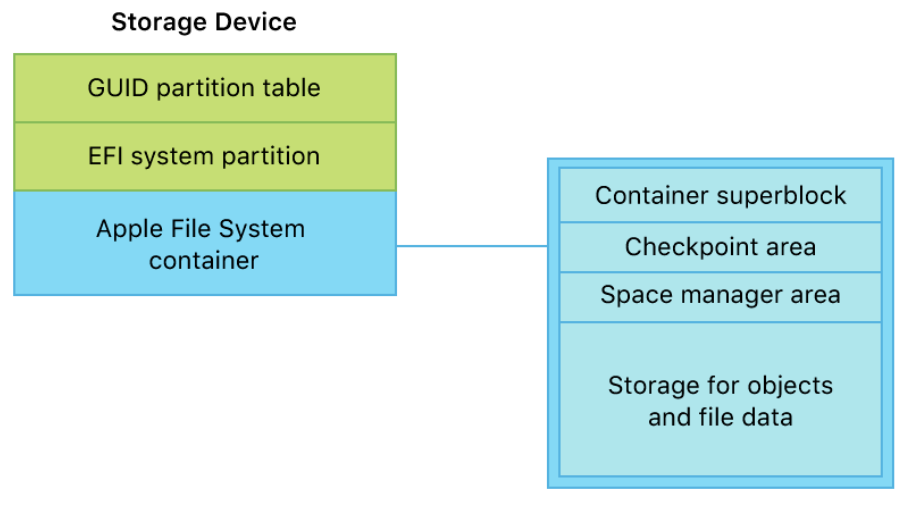
APFS 在概念上分为两层,容器层(Container Layer)和文件系统层(Filesystem Layer)。
ARCG

1. 容器层 - Container Layer

一个 APFS 分区有一个单独的容器,容器可以包含多个 volume(也称为 filesystem),每个卷都包含一个目录结构,用于管理 file 和 folder。
L0

  • Superblock:一个容器有多个超级块的副本,这些副本保存了容器在过去时间点的状态。Block 0 通常是最新的副本,用于在挂载过程中查找检查点。
  • Checkpoint:建立崩溃保护机制,每个事务结束时将临时对象写入磁盘并存储超级块的副本
  • Space manager:跟踪容器内的可用空间,并用于分配和释放存储对象和文件数据的块
  • OMAP(Object Map):基于B-树管理虚拟对象标识符和事务标识符的物理地址映射
  • Reaper:一种允许在跨越多个事务的时间段内删除大型对象的机制,单一容器内唯一实例

Container Superblock

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
struct nx_superblock { 
obj_phys_t nx_o;
uint32_t nx_magic; // magic ‘NXSB’
uint32_t nx_block_size; // 容器的已使用的逻辑块数量
uint64_t nx_block_count; // 容器的逻辑块总数
uint64_t nx_features; // 标记位,0x00000004 = NX_CRYPTO_SW,软件加密
uint64_t nx_readonly_compatible_features;
uint64_t nx_incompatible_features;
uuid_t nx_uuid; // 容器 UUID
oid_t nx_next_oid; // 下一个要使用的 oid
xid_t nx_next_xid; // 下一个要使用的 xid
uint32_t nx_xp_desc_blocks;
uint32_t nx_xp_data_blocks;
paddr_t nx_xp_desc_base;
paddr_t nx_xp_data_base;
uint32_t nx_xp_desc_next;
uint32_t nx_xp_data_next;
uint32_t nx_xp_desc_index;
uint32_t nx_xp_desc_len;
uint32_t nx_xp_data_index;
uint32_t nx_xp_data_len;
oid_t nx_spaceman_oid; // 空间管理器(临时对象) 的 oid
oid_t nx_omap_oid; // 对象映射(物理对象)的 oid
oid_t nx_reaper_oid; // 收割机(临时对象)的 oid
uint32_t nx_test_type;
uint32_t nx_max_file_systems;
oid_t nx_fs_oid[NX_MAX_FILE_SYSTEMS]; // Filesystem superblock (虚拟对象)oid 数组
uint64_t nx_counters[NX_NUM_COUNTERS];
prange_t nx_blocked_out_prange;
oid_t nx_evict_mapping_tree_oid;
uint64_t nx_flags;
paddr_t nx_efi_jumpstart;
uuid_t nx_fusion_uuid;
prange_t nx_keylocker; // 指向容器密钥包的物理位置
uint64_t nx_ephemeral_info[NX_EPH_INFO_COUNT];
oid_t nx_test_oid;
oid_t nx_fusion_mt_oid;
oid_t nx_fusion_wbc_oid;
prange_t nx_fusion_wbc;
uint64_t nx_newest_mounted_version;
prange_t nx_mkb_locker; // Wrapped media key
};

2. 卷宗层 - Volume Layer

Volume 是真正存储数据的,每个卷宗都有一个文件系统,核心组件包括:

  • Superblock:负责管理 volume 自己的一些配置信息,包含了各个组件的入口
  • Root Directory:负责以 B-树 方式存储文件结构信息,如目录结构、文件元数据和文件内容
  • OMAP:卷宗的大部分数据都是基于对象存储,因此每个卷宗都需要自己管理 OMAP
  • SNAP META Tree:负责管理快照的元数据,也是一个 B-树
  • Extentref Tree:负责管理快照扩展数据,还是一个 B-树

Volume Superblock

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
struct apfs_superblock { 
obj_phys_t apfs_o;
uint32_t apfs_magic; // magic 'BSPA'
uint32_t apfs_fs_index; // container Superblock 的 nx_fs_oid 数组的序号
uint64_t apfs_features;
uint64_t apfs_readonly_compatible_features;
uint64_t apfs_incompatible_features;
uint64_t apfs_unmount_time;
uint64_t apfs_fs_reserve_block_count;
uint64_t apfs_fs_quota_block_count;
uint64_t apfs_fs_alloc_count;
wrapped_meta_crypto_state_t apfs_meta_crypto; // 仅有密钥版本信息,因为VEK在密钥包!
uint32_t apfs_root_tree_type;
uint32_t apfs_extentref_tree_type;
uint32_t apfs_snap_meta_tree_type;
oid_t apfs_omap_oid; // 对象映射(物理对象)oid
oid_t apfs_root_tree_oid; // Root 文件系统树(虚拟对象)oid
oid_t apfs_extentref_tree_oid; // ?扩展参考树(物理对象)的 oid
oid_t apfs_snap_meta_tree_oid; // 快照元数据树(物理对象)的 oid
xid_t apfs_revert_to_xid; // 将要恢复到快照的 xid
oid_t apfs_revert_to_sblock_oid; // 将要恢复到快照的超级块副本的 oid
uint64_t apfs_next_obj_id; // 下一个要分配的对象 oid
uint64_t apfs_num_files; // 此卷宗的普通文件总数
uint64_t apfs_num_directories; // 此卷宗的目录总数
uint64_t apfs_num_symlinks; // 此卷宗的符号链接件总数
uint64_t apfs_num_other_fsobjects; // 此卷宗的其他类型文件总数
uint64_t apfs_num_snapshots; // 此卷宗的快照件总数
uint64_t apfs_total_blocks_alloced;
uint64_t apfs_total_blocks_freed;
uuid_t apfs_vol_uuid; // Volume UUID
uint64_t apfs_last_mod_time;
uint64_t apfs_fs_flags; // Flag定义,必须是 APFS_FS_ONEKEY
apfs_modified_by_t apfs_formatted_by;
apfs_modified_by_t apfs_modified_by[APFS_MAX_HIST];
uint8_t apfs_volname[APFS_VOLNAME_LEN];
uint32_t apfs_next_doc_id;
uint16_t apfs_role; // volume角色,定义见下
uint16_t reserved;
xid_t apfs_root_to_xid; // 快照的事务标识符,通常为零
oid_t apfs_er_state_oid;
uint64_t apfs_cloneinfo_id_epoch; // MacOS 10.13.3 之后,用于卷宗克隆
uint64_t apfs_cloneinfo_xid;
oid_t apfs_snap_meta_ext_oid; // 快照元数据扩展(虚拟对象)的 oid
uuid_t apfs_volume_group_id; // 归属 Volume Group 的 id
oid_t apfs_integrity_meta_oid; // 完整性元数据(虚拟对象)的 oid,MacOS 11 之后,用于 Sealed Volume
oid_t apfs_fext_tree_oid; // FILE EXTENT 树(虚拟对象)的 oid
uint32_t apfs_fext_tree_type;
uint32_t reserved_type;
oid_t reserved_oid;
};

至少有 4 个物理对象的 B-树 :ROOT DIRECTORY、EXTENT REFRENCE、SNAP METADATA、FILE EXTENT;还有一个虚拟对象的 OMAP B-树。

关于 ExtentRef Tree 的讨论

此问题已解决。ExtentRef Tree(范围参照树是)一个物理对象,就是当前正在构建的快照!
APFS 技术白皮书指出:

When a snapshot is created, the current extent-reference tree is moved to the snapshot.
A new, empty, extent-reference tree is created and its object identifier becomes the new value of this field.

当一个快照被创建时,当前的范围参照树就被移动到这个快照;同时,一个新的、空的范围参照树被创建,并将 volume superblock 的apfs_extentref_tree_oid置为这个新的 oid。

  • Object Type 定义 extent-reference tree 为OBJECT_TYPE_EXTENT_LIST_TREE
  • Volume Flag 的定义中,也有一个标记APFS_FS_ALWAYS_CHECK_EXTENTREF
  • j_snap_metadata_val_t 的结构中,包含extentref_tree_oid 和 extentref_tree_type 字段
  • volume superblock 的结构中,包含extentref_tree_oid 和 extentref_tree_type 字段

此外,APFS 白皮书还有一个勘误信息。

Corrected the discussion of object identifiers in j_snap_metadata_val_t.
The extentref_tree_oid and sblock_oid fields contain a physical object identifier, not a virtual object identifier.

二、通用组件

1. Object - 对象

APFS 的对象(Object)都有一个用于查找的唯一标识符oid,有三种不同的存储方法:

  • Ephemeral object(临时对象):当一个容器被加载后,临时对象存储在内存中。临时对象通常用于一些很少更新的数据,出于性能考虑允许在内存中修改,并在 checkpoint 时被持久化存储
  • Phycial Object(物理对象):存储在磁盘上的一个已知的物理块地址。物理对象被修改时,一个新副本将写入磁盘上的新位置,并携带一个不同的oid
  • Virtual Object(虚拟对象):同样存储在磁盘上的一个物理块地址。虚拟对象被修改时,一个新副本也将写入磁盘上的新位置,但是oid保持一致;通过 OMAP 可以查询虚拟对象,但必须提供一个事务标识符xid以指定您想要的时间点。
1
2
3
4
5
6
7
8
9
/* 所有对象的 header 定义 */
struct obj_phys {
uint8_t o_cksum[MAX_CKSUM_SIZE]; // 对象的64位弗莱彻校验值,类似 CRC 校验
oid_t o_oid;
xid_t o_xid;
uint32_t o_type; // 分成两部分,低16位是对象类型,高16位是存储方法
uint32_t o_subtype; // 对象在 B-树 的节点类型,借用 Object Types 定义
};
typedef struct obj_phys obj_phys_t;

当对象存储在磁盘上时,APFS 规定统一采用小端字节顺序,但设计思路有一些不同。容器对象以 block 为单位,并且包含填充字段使得数据长度是64的倍数,以避免内存访问对齐的性能损失;而文件系统对象以 byte 为单位,并且尽量最小化所使用的空间,因此很多 struct 定义都有__attribute__((aligned(8),packed))的编译标识。

2. B-Tree

B树(B-tree)是一种泛化的二叉搜索树(binary search tree),特点是每个节点具有两个以上的子节点,从而增加了键/值对的数量,减少定位记录时所经历的中间过程,从而加快访问速度;此外,B-树具备自平衡性,可以自动调整其结构以保持特定的平衡因子,从而保证在对数时间内进行操作,因此广泛应用于读写相对较大的数据块的存储系统。

HFS+ 是基于 B-树 设计的,APFS 也继承下来,其系统组件大量采用 B-树,例如 Filesystem、OMAP 和 snapshot 等。在 APFS 中,B-树 的节点对象称为 Node,分为根节点、中间节点和叶子节点,根节点 Root 是遍历整个树的起点。

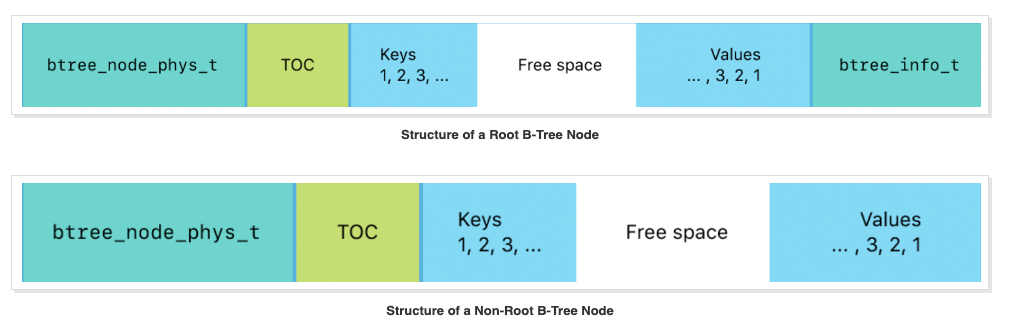
Node 的内部存储空间分为3个部分:TOC(table of content,表空间)、key area 和 vaule area,其中表空间保存了每个键值对的位置信息,Key 和 Value 从节点内部存储区域的首端和尾端开始分别存储,两者之间是共享的自由空间,这种以 offset 的形式存储,比存储完整位置使用更少的磁盘空间。

root 节点尾部增加了统计信息btree_info_t,为此可用存储空间少了 0x28 个字节。

B-Tree

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
/* B-树的定位信息 */
typedef struct nloc {
uint16_t off; // 偏移量(字节单位)
uint16_t len; // 长度(字节单位)
} nloc_t;

/* 普通 Node 的定义 */
struct btree_node_phys {
obj_phys_t btn_o; // 节点对象的头部
uint16_t btn_flags; // 标识位,区分 ROOT 或 LEAF
uint16_t btn_level; // 节点的等级
uint32_t btn_nkeys; // 存储了几个键值对
nloc_t btn_table_space; // 有数据区域的空间大小
nloc_t btn_free_space; // 空闲区域的空间大小
nloc_t btn_key_free_list; // Key 的可用空间列表
nloc_t btn_val_free_list; // Vaule 的可用空间列表
uint64_t btn_data[]; // 节点内部的存储空间
};
typedef struct btree_node_phys btree_node_phys_t;

/* 仅 Root Node */
struct btree_info {
btree_info_fixed_t bt_fixed; // 配置信息,如 Node、Key和Value的长度等
uint32_t bt_longest_key; // 最大 Key 的长度(字节单位)
uint32_t bt_longest_val; // 最大 Value 的长度(字节单位)
uint64_t bt_key_count; // Key 的总数量
uint64_t bt_node_count; // node 的总数量
};
typedef struct btree_info btree_info_t;

B+树是一个变种,区别是内部节点不存储任何指向记录的指针,这些指针仅存储在叶子节点,因此节点容量更大,树也更浅

三、 OMAP

在 APFS 中,OMAP(Object Maps,对象映射)扮演两个重要角色。一是负责根据 oid(虚拟对象标识符)和 xid(事务标识符)找到磁盘物理地址,二是提供快照功能,可以立即将虚拟对象回滚到较早的时间点。
Object Map 的定义如下:

1
2
3
4
5
6
7
8
9
10
11
12
13
struct omap_phys {                      
obj_phys_t om_o; // 标头
uint32_t om_flags; // OMAP 标识,见附表。注意对象内容可能被加密!
uint32_t om_snap_count; // 快照数量
uint32_t om_tree_type; // 目前是B-树
uint32_t om_snapshot_tree_type; // 目前是B-树
oid_t om_tree_oid; // 当前使用的 OMAP B-树的 (root)oid
oid_t om_snapshot_tree_oid; // 当前使用的 快照 B-树的 (root)oid
xid_t om_most_recent_snap; // 最新快照的 xid
xid_t om_pending_revert_min; // 正在回滚事务的 min xid
xid_t om_pending_revert_max; // 正在回滚事务的 max xid
};
typedef struct omap_phys omap_phys_t;

容器和每个卷都维护自己的 OAMP,每个 OMAP 都有自己的虚拟地址空间,因此对象定义要明确归属哪一个 B-Tree !
OMAP 使用 B-树 存储映射关系,其 Key / Value 的定义如下:

1
2
3
4
5
6
7
8
9
10
11
12
struct omap_key {
oid_t ok_oid; // 映射对象的虚拟对象标识符
xid_t ok_xid; // 映射对象的事务标识符
};
typedef struct omap_key omap_key_t;

struct omap_val {
uint32_t ov_flags; // 标记位,见附录。注意物理存储可能被加密!!!
uint32_t ov_size; // 映射对象的大小(字节单位)
paddr_t ov_paddr; // 映射对象起点的物理地址
};
typedef struct omap_val omap_val_t;

有意思的是,OMAP 本身也有一个快照,定义如下:

1
2
3
4
5
6
struct omap_snapshot { 
uint32_t oms_flags; // OMAP_SNAPSHOT_DELETED or OMAP_SNAPSHOT_REVERTED
uint32_t oms_pad;
oid_t oms_oid;
};
typedef struct omap_snapshot omap_snapshot_t;

OMAP 的查询流程

使用 OMAP 访问虚拟对象时,应遵循如下流程:

  1. 确定对象映射的入口。
    volume 的对象使用该卷宗的 OMAP,入口是apfs_superblock_t的apfs_omap_oid字段;
    否则,所有其他对象应使用容器的 OMAP,入口是nx_superblock_t的nx_omap_oid字段
  2. 读取omap_phys_t的om_tree_oid字段用于定位对象映射的 B-树
  3. 在 B-树 中搜索ok_oid == 期望的oid,而且ok_xid <= 期望的xid 的 key。如果有多个 key 满足要求,则使用具有最大xid的 key
  4. 使用 Node 节点的 TOC,读取这个 key 对应的 value,其中包含物理地址ov_addr和ov_size
  5. 从磁盘的物理地址获得对象数据

四、File System

每个 APFS 卷宗(Volume)都有一个文件系统(Filesystem)。
与其他 APFS 对象(Object)不同,文件系统对象由一个或多个文件系统记录(Record)组成,这些记录存储在 Volume 的 FileSystem Tree 上,每条记录都存储有关 file 或 directory 的特定信息。
所有文件系统对象是基于一个专用的 B-Tree 来组织的,并具有以下特点:

  • 文件系统树是虚拟的,其每个节点都是基于 Volume 的 OMAP 映射出来的虚拟对象。这意味着,检索文件系统树必须依赖 OMAP 定位以查找每个节点
  • 文件系统树支持快照功能,即充分利用 OMAP 的快照功能将其状态恢复到以前的时间点,Time Machine 的增量备份功能就是一个典型应用
  • 可以选择对文件系统的节点进行加密,不仅可以加密文件内容,还可以加密文件元数据
  • 文件系统树存储了一组异构记录,也即是说,多种类型的键和值都存储在同一树中

文件系统树的每个节点都有唯一标识j_key。

1
2
3
4
5
6
7
#define OBJ_ID_MASK     0x0fffffff'ffffffff
#define OBJ_TYPE_MASK 0xf0000000'00000000
#define OBJ_TYPE_SHIFT 60

typedef struct j_key {
uint64_t obj_id_and_type;
} j_key_t;

为了充分利用内存空间,前 4 个字节是记录(Record)的类型定义,包括:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
typedef enum { 
APFS_TYPE_ANY = 0,
APFS_TYPE_SNAP_METADATA = 1, // 快照的元数据
APFS_TYPE_EXTENT = 2, // 物理扩展信息
APFS_TYPE_INODE = 3, // 必选项!最核心的元数据
APFS_TYPE_XATTR = 4, // TODO:似乎用于支持文件系统Fork的功能
APFS_TYPE_SIBLING_LINK = 5, // 标记一个 inode 节点被那些硬链接所引用的映射
APFS_TYPE_DSTREAM_ID = 6, // 重要!默认数据流的入口和调用计数器 rfcnt
APFS_TYPE_CRYPTO_STATE = 7, // 重要!数据保护等级
APFS_TYPE_FILE_EXTENT = 8, // 重要!文件扩展信息,crypto_id 就在这里
APFS_TYPE_DIR_REC = 9, // 保存该目录的成员信息,filename 就在这里
APFS_TYPE_DIR_STATS = 10, // 目录的统计信息,包括成员数量、总容量、父目录oid等
APFS_TYPE_SNAP_NAME = 11, // 快照名称
APFS_TYPE_SIBLING_MAP = 12, // 标记一个硬链接文件的目标 inode 节点的映射
APFS_TYPE_FILE_INFO = 13,

APFS_TYPE_MAX_VALID = 13,
APFS_TYPE_MAX = 15,
APFS_TYPE_INVALID = 15,
} j_obj_types;

1. 文件和目录

文件系统树的每个节点都必须有 inode 记录,第一条记录就是 Root Directory。

INODE 记录

inode 负责管理最核心的元数据,例如时间戳、类型、所有者和权限等,都是固定长度的标准格式,其他信息将被存入 inode 的扩展字段,或者其他类型的 Record 中

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
/* inode 数据结构 */
struct j_inode_key {
j_key_t hdr; // = header, key & value
} __attribute__((packed));

struct j_inode_val {
uint64_t parent_id; // 所在目录的ID
uint64_t private_id; // 默认数据流的ID!
uint64_t create_time;
uint64_t mod_time;
uint64_t change_time;
uint64_t access_time;
uint64_t internal_flags; // 标志位
union { // 仅用于目录
int32_t nchildren;
int32_t nlink;
};
cp_key_class_t default_protection_class; // 默认数据保护级别
uint32_t write_generation_counter;
uint32_t bsd_flags;
uid_t owner;
gid_t group;
mode_t mode;
uint16_t pad1;
uint64_t uncompressed_size;
uint8_t xfields[]; // 扩展字段的入口
} __attribute__((packed));
typedef struct j_inode_val j_inode_val_t;
Extended Fields(扩展字段)

inode 记录支持有限的扩展字段(Extended Fields),入口就在uint8_t xfield[],其类型定义包括:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
#define INO_EXT_TYPE_SNAP_XID           1       // 快照的事物标识符xid
#define INO_EXT_TYPE_DELTA_TREE_OID 2 // 与快照的增量列表对应的文件系统B-树的虚拟对象标识符
#define INO_EXT_TYPE_DOCUMENT_ID 3 // 文档标识符,用于大量文件的目录更改期间的事务完整性
#define INO_EXT_TYPE_NAME 4 // 硬链接指向的文件名!
#define INO_EXT_TYPE_PREV_FSIZE 5 // 文件以前的长度
#define INO_EXT_TYPE_RESERVED_6 6
#define INO_EXT_TYPE_FINDER_INFO 7 // Finder的提示信息,Apple自定义
#define INO_EXT_TYPE_DSTREAM 8 // 数据流,即文件内容数据
#define INO_EXT_TYPE_RESERVED_9 9
#define INO_EXT_TYPE_DIR_STATS_KEY 10 // 有关目录的统计信息
#define INO_EXT_TYPE_FS_UUID 11 // 自动挂载到该目录的文件系统UUID(考虑/etc/fstab)
#define INO_EXT_TYPE_RESERVED_12 12
#define INO_EXT_TYPE_SPARSE_BYTES 13 // 数据流中的稀疏字节数量
#define INO_EXT_TYPE_RDEV 14 // 块设备或字符专用设备的标识符
#define INO_EXT_TYPE_PURGEABLE_FLAGS 15
#define INO_EXT_TYPE_ORIG_SYNC_ROOT_ID 16

inode 记录的扩展字段INO_EXT_TYPE_NAME,存储的并不是该节点的文件名,而是在该节点是一个硬链接的场景下,其对应的源目标文件名

DIR_REC 记录

当我们新建一个文件目录时,当然必须创建一个 inode 记录,此时它是一个空目录。
然后,我们继续在该目录下新建一个文件时,需要新增 2 条记录,一是新文件的 inode 记录,二是 DIR_REC 记录,用于该目录管理其子对象,也就是说,一个目录下有几个文件或子目录,就有几条 DIR_REC 记录。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
struct j_drec_hashed_key { 
j_key_t hdr;
uint32_t name_len_and_hash; // 最低10位是 filename 的长度,前面是文件名的哈希值
uint8_t name[0]; // filename!UTF-8编码格式,NULL结尾
} __attribute__((packed));
typedef struct j_drec_hashed_key j_drec_hashed_key_t;

#define J_DREC_LEN_MASK 0x000003ff
#define J_DREC_HASH_MASK 0xfffff400
#define J_DREC_HASH_SHIFT 10

struct j_drec_val {
uint64_t file_id; // 子成员的ID
uint64_t date_added; // 添加到该目录的时间戳
uint16_t flags; // 标记该成员的类型,例如普通文件、目录、块设备、软连接、Socket等
uint8_t xfields[];
} __attribute__((packed));
typedef struct j_drec_val j_drec_val_t;
  • 找了很久 filename 的存储方式,最后发现不在 File 的 inode 记录中,而是藏在归属目录的 DIR_REC 记录中!因为操作系统处理时只需要唯一标识符j_key,其实文件名只是提供用户查询显示的
  • 早期版本的 APFS 使用j_drec_key,后来升级为j_drec_hashed_key,区别就是增加了文件名的哈希值,这个变化非常有利于提高长文件名的搜索效率,即不用逐一比较字符串,而是直接比较哈希值即可
  • DIR_REC 记录同样支持扩展字段,其定义与 inode 记录保持一致

2. 数据流

类似 filename 的短数据可以存储在 metadata 之中,但是文件内容和一些属性值的数据量不固定而且可能很大,基于性能考虑,APFS 将这些数据存储在 Data Stream 数据流之中。

DSTREAM 记录

每个文件都有一个默认数据流,存储我们通常所说的文件内容。
还记得 inode 记录中的private_id吗?这就是每个文件的默认数据流(Data Stream)。

1
2
3
4
5
6
7
8
9
struct j_dstream_id_key { 
j_key_t hdr;
} __attribute__((packed));
typedef struct j_dstream_id_key j_dstream_id_key_t;

struct j_dstream_id_val {
uint32_t refcnt; // 如果数据流的引用计数清零时,可以删除之
} __attribute__((packed));
typedef struct j_dstream_id_val j_dstream_id_val_t;

默认数据流的统计信息保存在 inode 记录的APFS_TYPE_EXTENT扩展字段。
数据流的占用空间和分配空间可能不一致,例如文件内容没有完全填满最后一个块,此外,由于 AFPS 支持稀疏分配,重复出现的零字节可能不会实际占用存储空间。
对于使用软件加密的 volume,default_crypto_id字段的值始终为CRYPTO_SW_ID=4。

1
2
3
4
5
6
7
8
struct j_dstream {
uint64_t size; // 逻辑数据的大小(以字节为单位)
uint64_t alloced_size; // 为数据流分配的总空间(以字节为单位),包括未使用的空间
uint64_t default_crypto_id; // TODO: 此数据流中使用的默认加密密钥,或 Tweak 密钥
uint64_t total_bytes_written; // 已写入此数据流的总字节数
uint64_t total_bytes_read; // 已从此数据流读取的总字节数
} __attribute__((aligned(8),packed));
typedef struct j_dstream j_dstream_t;

XATTR 记录

古老的 HFS+ 提供了文件系统的fork功能,最初设计是为了保存 GUI 使用的非编译数据,例如文件图标、缩略图和应用程序相关的菜单提示信息等,这个功能 AFPS 继承下来,并基于APFS_TYPE_XATTR记录实现。

微软的 NTFS 也有类似功能,称为 ADS(Alternate data stream,替代数据流)

1
2
3
4
5
6
7
8
9
10
11
12
13
struct j_xattr_key { 
j_key_t hdr;
uint16_t name_len; // 扩展属性名称的长度(字节单位)
uint8_t name[0]; // 以NULL结尾的UTF-8编码
} __attribute__((packed));
typedef struct j_xattr_key j_xattr_key_t;

struct j_xattr_val {
uint16_t flags; // 数据存储位置标记:数据流、记录、文件系统
uint16_t xdata_len; // 扩展属性的内联数据长度
uint8_t xdata[0]; // 扩展属性的内容,或者数据流的标识符
} __attribute__((packed));
typedef struct j_xattr_val j_xattr_val_t;

3. 密钥管理

早期的 HFS+ 采用 AES-CBC 工作模式,存在明文和密文不等长、需要额外存储初始变量等诸多问题,后续改为 AES-XTS 磁盘加密模式,APFS 也是如此,这就需要妥善保管好 Ciper 分组密钥和 Tweak 可调整密钥。

CRYPTO_STATE 记录

请注意!本文讨论的是软件加密,也就是单一密钥的 FDE,并不需要管理每个文件的 AES-XTS的主密钥,但 APFS 的设计目标是原生支持 FBE(当然前提是采用硬件加密),因此数据结构的设计目标就是每个文件都有独立的 per-file key,就保存在APFS_TYPE_CRYPTO_STATE记录。

1
2
3
4
5
6
7
8
struct j_crypto_key { 
j_key_t hdr;
} __attribute__((packed));

struct j_crypto_val {
uint32_t refcnt;
wrapped_crypto_state_t state;
} __attribute__((aligned(4),packed));

进一步,我们来分析wrapped_crypto_state_t的数据结构,可以看到 per-file key 始终是以包裹状态存储的,需要通过安全隔区保存的 Class Key 来解密。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
/* 持久化存储 per-file key,包含:版本信息 + warpped key data */
struct wrapped_crypto_state { //
uint16_t major_version; // default = 5,iOS 5开始支持 FBE
uint16_t minor_version; // default = 0
crypto_flags_t cpflags;
cp_key_class_t persistent_class; // 数据保护等级:A/B/C/D
cp_key_os_version_t key_os_version; // OS版本号,例如:18-A-391
cp_key_revision_t key_revision;
uint16_t key_len;
uint8_t persistent_key[0]; // warpped per-file key !!!
} __attribute__((aligned(2), packed));

/* 结构相似,但没有密钥数据!仅用于 AFPS Superblock,因为总是使用单一密钥 VEK */
struct wrapped_meta_crypto_state {
uint16_t major_version;
uint16_t minor_version;
crypto_flags_t cpflags;
cp_key_class_t persistent_class;
cp_key_os_version_t key_os_version;
cp_key_revision_t key_revision;
uint16_t unused;
} __attribute__((aligned(2), packed));

FILE_EXTENT 记录

还记得 HFS+ 是如何实现 HBE 的吗?就是将per-file key保存在文件扩展信息中。APFS 继承了这种方式,将 Tweak key 保存在APFS_TYPE_FILE_EXTENT记录中。

需要注意的是,由于APFS 支持 COW(Copy On Write,写入时拷贝),可以实现零损耗的大文件快速克隆。但是,如果一个文件被 Clone 以后,每个副本都会获得一个新密钥以接受后续可能的数据写入,久而久之,一个文件可能会由不同的范围(或片段)组成,每个映射到不同的密钥,为此可能需要多个AFPS_FILE_EXTENT记录。

此外,由于 Tweak Key 属于密钥白化技术,不允许重复使用,但可以被公开,因此 crypto_id 可以明文存储。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
struct j_file_extent_key { 
j_key_t hdr;
uint64_t logical_addr;
} __attribute__((packed));

struct j_file_extent_val {
uint64_t len_and_flags; // 最高8位是标记位(当前未使用),后续56位是数据块长度(字节单位)
uint64_t phys_block_num; // 第一个块的物理块号
uint64_t crypto_id; // FDE 模式下存储 Tweak Key!如果未加密,置为0
} __attribute__((packed));
typedef struct j_file_extent_val j_file_extent_val_t;

#define J_FILE_EXTENT_LEN_MASK 0x00ffffffffffffffULL
#define J_FILE_EXTENT_FLAG_MASK 0xff00000000000000ULL
#define J_FILE_EXTENT_FLAG_SHIFT 56
关于 crypto_id 的讨论
  • 该字段的默认值是此区段所属的数据流的j_dstream_t的default_crypto_id字段的值
  • 如果在 Volume 设置了APFS_FS_ONEKEY标志,即单一密钥模式,该字段存储 AES-XTS 的 Tweak key
  • 否则,该字段存储数据与j_crypto_key_t记录的obj_id字段保持一致,表明将采用 FBE 模式,此时这里不需要存储 Tweak key

根据 Apple 安全隔区白皮书的说明:
在搭载 A14 和 M1 的设备上, 加密在 XTS 模式中使用 AES-256, 其中 256 位文件独有密钥通过密钥派生功能 (NIST Special Publication 800-108) 派生出一个 256 位 tweak 密钥和一个 256 位 cipher 密钥。
采用 A9 到 A13、 S5 和 S6 的每一代硬件在 XTS 模式中使用 AES-128, 其中 256 位文件独有密钥会被拆分, 以提供一个 128 位 tweak 密钥和一个 128 位 cipher 密钥。

五、Keybag

APFS 的设计原生支持加密,不再需要 HFS+ 上叠加的 CoreStorge 虚拟存储层,但具体加密方式取决于硬件设备的功能。硬件加密用于具备 Secure Encalve 安全隔区的内部存储设备,软件加密用于不支持硬件加密的外部和内部存储设备。需要注意的是,当使用硬件加密时,数据无法在任何其他设备上解密,安全芯片必须代理所有解密操作。

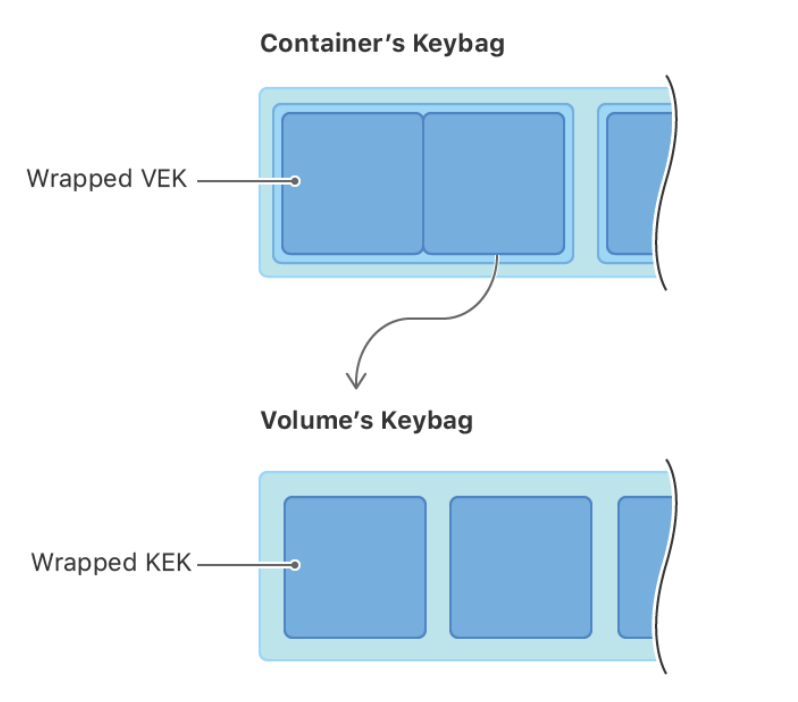
对于 macOS,APFS 使用单一密钥 VEK(Volume Encryption Key,卷宗加密密钥)访问宗卷上的加密内容(也就是所有文件的 AES-XTS 分组密钥),VEK 以 Warpped 状态存储在磁盘,封装在多层加密中。

KEK(Key Encryption Key,密钥加密密钥)是用于打开 VEK 的包裹密钥,以加密形式存储在磁盘上。每个 Volume 都有自己的 KEK ,而且还有多个副本以提供不同场景下的用户访问,这些副本都使用不同的密钥进行加密(包装),包括:

  • User Password:用户输入登录密码
  • Personal recovery key:个人备份密钥,该密钥在驱动器格式化时生成,并由用户纸质保存
  • Institutional recovery key:授权的外部机构恢复密钥
  • iCloud recovery key:客户与 Apple 技术支持配合使用
L1

1. Keybag 的存储方式

早期的 iOS 将密钥包存储在一个普通的数据文件中(/private/var/keybags/systembag.kb),虽然做了很复杂的加密处理,但由于缺少防重放机制,无法有效抵御暴力破解。APFS 是基于文件系统的全新设计,密钥包不再依赖于数据文件,而是被设计为一个特殊的对象(Object)。

Container Keybag 的入口在其超级块nx_superblock_t的prangnx_keylocker字段,数据类型是prange_t,保存着容器密钥包的物理地址,其数据结构是:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
/* keybag 的头部 */
struct kb_locker {
uint16_t kl_version; // 版本号,目前为 2
uint16_t kl_nkeys; // 包含了几个条目
uint32_t kl_nbytes;
uint8_t padding[8];
keybag_entry_t kl_entries[]; // 密钥条目数组,结构见下
};
typedef struct kb_locker kb_locker_t;

/* keybag 的各个条目 */
struct keybag_entry {
uuid_t ke_uuid; // 如果是容器,存储Volume UUID;如果是Volume,存储User UUID
uint16_t ke_tag; // 标签,定义见下
uint16_t ke_keylen; //
uint8_t padding[4];
uint8_t ke_keydata[]; // 内容数据块!!!
};
typedef struct keybag_entry keybag_entry_t;

#define APFS_VOL_KEYBAG_ENTRY_MAX_SIZE 512
#define APFS_FV_PERSONAL_RECOVERY_KEY_UUID ”EBC6C064-0000-11AA-AA11-00306543ECAC”

/* keybag 的标签定义 */
enum {
KB_TAG_UNKNOWN = 0,
KB_TAG_RESERVED_1 = 1,
KB_TAG_VOLUME_KEY = 2, // 标记是wrapped VEK,仅用于容器密钥包
KB_TAG_VOLUME_UNLOCK_RECORDS = 3, // MacOS专用!容器和卷宗的解锁信息,具体见下文
KB_TAG_VOLUME_PASSPHRASE_HINT = 4, // MacOS专用!user password的提示语(明文)
KB_TAG_WRAPPING_M_KEY = 5, // iOS专用!media key 的包裹密钥
KB_TAG_VOLUME_M_KEY = 6, // iOS专用!本volume的media key
KB_TAG_RESERVED_F8 = 0xF8
};

对于 Container Keybag,容器包含了几个加密的 Volume,就有几个 entry:

  • 每个 entry 的ke_uuid存储了这个 volume 的 UUID,也是后续用于解封 volume keybag 的钥匙
  • 每个 entry 的ke_keydata存储了这个 volume keybag 的物理地址

对于 Volume Keybag ,卷宗包含了几个 User,就有几个 entry

  • 每个 entry 的ke_uuid存储了这个 User 的 UUID
  • 每个 entry 的ke_keydata存储了这个 User 的 wrapped KEK

2. VEK 的解封流程

要完成数据文件的解密,是一个漫长而复杂的流程。

Step 1: 解封 Container Keybag

  • 读取容器超级块的nx_keylocker字段,找到容器密钥包的物理位置。然而你不能直接看到数据,因为密钥包的内容被加密了。
  • 执行解密算法RFC 3394 - AES密钥包裹算法,密钥就是该容器的 UUID,即容器超级块的nx_uuid字段。

现在,你就能看到容器密钥包的数据内容了。

此处JOE 的参考文档和 APFS 官方文档不一致

Step 2: 找到 wrapped VEK

分析容器密钥包,找到一个标记为KB_TAG_VOLUME_KEY的 entry,其ke_keydata字段就是 wrapped VEK。
先保存下来,后面还要用。

Step 3: 解封 Volume Keybag

  • 继续分析容器密钥包,找出标记为KB_TAG_VOLUME_KEY的 entry,可能有多个分别对应不同的卷宗.
    每个 entry 的ke_uuid字段是 volume UUID,ke_keydata字段是 volume keybag 的物理地址
  • 根据 Volume keybag 的物理地址读取数据,然而你还是看不到内容,因为又被加密了。
    仍然执行解密算法 RFC 3394,密钥是该 volume 的 UUID
  • 标记为KB_TAG_VOLUME_PASSPHRASE_HINT的 entry,其ke_keydata存储人类可读的密码提示信息

现在,你就能看到卷宗密钥包的数据内容了,示例如下:

名字 UUID
INSTITUTIONAL_RECOVERY_UUID {C064EBC6-0000-11AA-AA11-00306543ECAC}
INSTITUTIONAL_USER_UUID {2FA31400-BAFF-4DE7-AE2A-C3AA6E1FD340}
PERSIONAL_RECOVERY_UUID {EBC6C064-0000-11AA-AA11-00306543ECAC}
ICLOUD_RECOVERY_UUID {64C0C6EB-0000-11AA-AA11-00306543ECAC}
ICLOUD_USER_UUID {EC1C2AD9-B618-4ED6-BD8D-50F361C27507}

Step 4: 找到 wrapped KEK

分析卷宗密钥包,包含了多个 entry,分别对应不同的 User,也是不同的业务场景。

以用户密码方式为例,你需要找出一条 entry,其ke_uuid是某个User Open Directory UUID,而且标记为KB_TAG_VOLUME_UNLOCK_RECORDS,其ke_keydata字段就是这个场景的 wrapped KEK。

Step 5: 解封 KEK

KEK 是基于 DER 编码的数据块,其结构为:

1
2
3
4
5
6
7
8
9
10
11
12
13
KEKBLOB ::= SEQUENCE {
unknown [0] INTEGER
hmac [1] OCTET STRING // 校验值
salt [2] OCTET STRING
keyblob [3] SEQUENCE {
unknown [0] INTEGER
uuid [1] OCTET STRING // Volume User UUID
flags [2] INTEGER // 标记是基于CoreStorage,APFS软件加密,或硬件加密
wrapped_key [3] OCTET STRING //
iterations [4] INTEGER // 迭代次数
salt [5] OCTET STRING // 盐值
}
}

数据块的头部有一个 基于 HMAC-SHA256 算法的校验值,算法是:
hmac_key := SHA256("\x01\x16\x20\x17\x15\x05" + salt)

Flags 标记了 KEK 的包裹方式,格式如下:

Name Value Description
KEK_FLAG_CORESTORAGE 0x00010000’0000000000 Key is a legacy CoreStorage KEK
KEK_FLAG_HARDWARE 0x00020000’0000000000 Key is hardware encrypted

解密算法是 PBKDF2 和 RFC 3394,你必须知道 User Password 并计算出 Passcode Key,才能正确解封 wrapped KEK,算法是:

1
2
3
4
5
6
7
8
// Calculate size of wrapping key (in bytes)
key_size := (flags & KEK_FLAG_CORESTORAGE) ? 16 : 32

// Generate unwrapping key from user's password
key := pbkdf2_hmac_sha256(password, salt, iterations, key_size)

// Unwrap the encrypted KEK
kek := rfc3394_unwrap(key, wrapped_key);

Step 6: 解封 VEK

KEK 也是基于 DER 编码的数据块,结构更简单:

1
2
3
4
5
6
7
8
9
10
11
VEKBLOB ::= SEQUENCE {
unknown [0] INTEGER
hmac [1] OCTET STRING
salt [2] OCTET STRING
keyblob [3] SEQUENCE {
unknown [0] INTEGER
uuid [1] OCTET STRING
flags [2] INTEGER
wrapped_key [3] OCTET STRING
}
}

解密算法就是简单的 RFC 3394。
vek = rfc3394_unwrap(vek, wrapped_key)

至此,我们终于获得了核心密钥 VEK !!!

3. 文件解密的流程

APFS 采用 XTS-AES-128 磁盘加密模式,该密码使用 256 位分组密钥和 64 位调整值。此调整值取决于位置。它允许对相同的明文进行加密并存储在磁盘上的不同位置,并且在使用相同的 AES 密钥时具有截然不同的密文。每 512 字节的加密数据使用基于块初始存储的容器偏移量的调整。

要顺利完成文件内容解密,前提条件包括:

  1. 准确解析文件系统的B-Tree
  2. 解析密钥包,找到分组密钥 Ciper Key,也即是 VEK
  3. 找到文件密钥,也就是 Tweak key

文件元数据的解密

卷的对象映射永远不会加密,但其引用的虚拟对象可能会加密,就像加密卷上的 FS 树节点一样。

1
2
3
4
5
typedef struct omap_val {
uint32_t ov_flags; // 0x00
uint32_t ov_size; // 0x04
paddr_t ov_paddr; // 0x08
} omap_val_t; // 0x10

如果ov_flags设置了OMAP_VAL_ENCRYPTED标志位,则位于ov_paddr的虚拟对象已经被加密,
对于第一个512字节的数据块,可以基于物理位置确定 Tweak value,后续512字节的数据块则依次递增。

uint64_t tweak0 = (ov_paddr * block_size) / 512;

文件内容的解密

  1. 基于 Volume Superblock 的apfs_root_tree_oid字段找到 Root Directory 的对象映射
  2. 使用 VEK 作为AES-XTS 主密钥,解封并访问文件系统树
  3. 查找加密文件的文件范围记录APFS_TYPE_FILE_EXTENT
  4. 查找加密状态记录APFS_TYPE_CRYPTO_STATE,其标识符等于j_file_extent_val.crypto_id
  5. 使用 VEK 作为主密钥,Crypto_id的值作为 Tweak key,执行 AES-XTS 解密相应的数据块

TODO: 第四步来自 APFS白皮书,似乎 FDE 模式不需要?

六、Snapshot

快照(Snapshot)是现代文件系统的重要功能,可以在给定时间点获得一个稳定的、只读的文件系统副本,例如用于硬盘的增量备份。快照的设计目标是可以快速而且低成本的创建,但付出的代价是删除快照需要更多的工作。

1. Snapshot Metadata Record

快照也是一个基于 B-树 的应用,鉴于快照的数据量可能较大,因此又建立了一个名为Extent Reference的 B-树 用于保存实际的内容数据,而在 snapshot 记录中仅保存其元数据 metadata ,定义如下:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
struct j_snap_metadata_key { 
j_key_t hdr; // 就是这个快照对应的 xid
} __attribute__((packed));
typedef struct j_snap_metadata_key j_snap_metadata_key_t;

struct j_snap_metadata_val {
oid_t extentref_tree_oid; // 内容数据的 oid,保存在 ExtentRef tree
oid_t sblock_oid; // 快照为卷宗超级块建立副本,这是超级块的 oid
uint64_t create_time;
uint64_t change_time;
uint64_t inum;
uint32_t extentref_tree_type; // 默认就是 B-树
uint32_t flags;
uint16_t name_len;
uint8_t name[0]; // 快照名称,UTF-8编码
} __attribute__((packed));
typedef struct j_snap_metadata_val j_snap_metadata_val_t;

2. Snapshot Name Records

快照名称记录用于将快照名称映射到其事务标识符。

1
2
3
4
5
6
7
8
9
10
11
struct j_snap_name_key { 
j_key_t hdr;
uint16_t name_len;
uint8_t name[0];
} __attribute__((packed));
typedef struct j_snap_name_key j_snap_name_key_t;

struct j_snap_name_val {
xid_t snap_xid; // 快照中最后一个事务的 xid
} __attribute__((packed));
typedef struct j_snap_name_val j_snap_name_val_t;

3. Snapshot Extended Reference Metadata Object

每个快照都有一个虚拟对象,用于保存快照扩展信息的元数据,其 oid 保存在该卷宗超级块的apfs_snap_meta_ext_oid字段中,映射关系记录在该卷宗的 OMAP 上。快照的虚拟对象有多个版本,其事务标识符 xid 对应每个版本。

Each snapshot has a virtual Snapshot Extended Metadata Object in the volume’s Object Map. The virtual object identifier of this object is stored in the apfs_snap_meta_ext_oid field of the Volume Superblock. There are multiple versions of this object whose transaction identifiers correspond to each snapshot.

1
2
3
4
5
6
7
8
9
10
11
12
13
14
struct snap_meta_ext_obj_phys { 
obj_phys_t smeop_o;
snap_meta_ext_t smeop_sme; // 具体结构在下面
}
typedef struct snap_meta_ext_obj_phys_t;

typedef struct snap_meta_ext {
uint32_t sme_version; // 当前版本号=1
uint32_t sme_flags;
xid_t sme_snap_xid; // 快照对应的 xid
uuid_t sme_uuid; // 快照的 UUID
uint64_t sme_token;
} __attribute__((packed))
typedef struct snap_meta_ext snap_meta_ext_t;

七、遗留问题

1. AFPS 白皮书中介绍的 media_keybag 是什么?

1
2
3
4
struct media_keybag {
obj_phys_t mk_obj;
kb_locker_t mk_locker; // 密钥包入口,结构见下!
}

2020年6月,增加定义:#define OBJECT_TYPE_MEDIA_KEYBAG 'mkey'
APFS 的描述:A keybag, wrapped up as a container-layer object.
nx_mkb_locker : Wrapped media key.

KB_TAG_WRAPPING_M_KEY:
The key data stores a key thatʼs used to wrap a media key.

初步分析,media key 应该是 2020年 Apple 版本升级的产物,负责封装数据宗卷上的元数据。

Apple 安全白皮书介绍:

When deleting a volume, its volume encryption key is securely deleted by the Secure Enclave.
This helps prevent future access with this key even by the Secure Enclave.
In addition, all volume encryption keys are wrapped with a media key.
The media key doesn’t provide additional confidentiality of data; instead, it’s designed to enable swift and secure deletion of data because without it decryption is impossible.
On a Mac with Apple silicon and those with the T2 chip, the media key is guaranteed to be erased by the Secure Enclave supported technology—for example by remote MDM commands.
Erasing the media key in this manner renders the volume cryptographically inaccessible.
media key Part of the encryption key hierarchy that helps provide for a secure and instant wipe.
In iOS, iPadOS, tvOS, and watchOS, the media key wraps the metadata on the data volume (and thus without it access to all per-file keys is impossible, rendering files protected with Data Protection inaccessible).
In macOS, the media key wraps the keying material, all metadata, and data on the FileVault protected volume. In either case, wipe of the media key renders encrypted data inaccessible.


附录一:一些重要的类型定义

1. Object Type 的定义

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
#define OBJECT_TYPE_NX_SUPERBLOCK       0x00000001  // Container superblock

#define OBJECT_TYPE_BTREE 0x00000002 // Root node
#define OBJECT_TYPE_BTREE_NODE 0x00000003 // inode

#define OBJECT_TYPE_SPACEMAN 0x00000005 // Space Manager
#define OBJECT_TYPE_SPACEMAN_CAB 0x00000006
#define OBJECT_TYPE_SPACEMAN_CIB 0x00000007
#define OBJECT_TYPE_SPACEMAN_BITMAP 0x00000008
#define OBJECT_TYPE_SPACEMAN_FREE_QUEUE 0x00000009

#define OBJECT_TYPE_EXTENT_LIST_TREE 0x0000000a
#define OBJECT_TYPE_OMAP 0x0000000b // Object Map, B-Tree
#define OBJECT_TYPE_CHECKPOINT_MAP 0x0000000c // Checkpoint

#define OBJECT_TYPE_FS 0x0000000d
#define OBJECT_TYPE_FSTREE 0x0000000e
#define OBJECT_TYPE_BLOCKREFTREE 0x0000000f
#define OBJECT_TYPE_SNAPMETATREE 0x00000010

#define OBJECT_TYPE_NX_REAPER 0x00000011
#define OBJECT_TYPE_NX_REAP_LIST 0x00000012
#define OBJECT_TYPE_OMAP_SNAPSHOT 0x00000013
#define OBJECT_TYPE_EFI_JUMPSTART 0x00000014

#define OBJECT_TYPE_FUSION_MIDDLE_TREE 0x00000015 // Fusion是Apple开发的混合磁盘技术
#define OBJECT_TYPE_NX_FUSION_WBC 0x00000016
#define OBJECT_TYPE_NX_FUSION_WBC_LIST 0x00000017

#define OBJECT_TYPE_GBITMAP 0x00000019
#define OBJECT_TYPE_GBITMAP_TREE 0x0000001a
#define OBJECT_TYPE_GBITMAP_BLOCK 0x0000001b
#define OBJECT_TYPE_ER_RECOVERY_BLOCK 0x0000001c
#define OBJECT_TYPE_SNAP_META_EXT 0x0000001d
#define OBJECT_TYPE_INTEGRITY_META 0x0000001e
#define OBJECT_TYPE_FEXT_TREE 0x0000001f
#define OBJECT_TYPE_RESERVED_20 0x00000020
#define OBJECT_TYPE_INVALID 0x00000000
#define OBJECT_TYPE_TEST 0x000000ff

#define OBJECT_TYPE_CONTAINER_KEYBAG 'keys'
#define OBJECT_TYPE_VOLUME_KEYBAG 'recs'
#define OBJECT_TYPE_MEDIA_KEYBAG 'mkey'

2. Object Flag 的定义

区分存储方式,即:虚拟对象、物理对象、或临时对象

1
2
3
4
5
6
7
#define OBJ_VIRTUAL         0x00000000
#define OBJ_EPHEMERAL 0x80000000
#define OBJ_PHYSICAL 0x40000000

#define OBJ_NOHEADER 0x20000000
#define OBJ_ENCRYPTED 0x10000000
#define OBJ_NONPERSISTENT 0x08000000

3. Volume Flag 的定义

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
#define APFS_FS_UNENCRYPTED                 0x00000001LL
#define APFS_FS_RESERVED_2 0x00000002LL
#define APFS_FS_RESERVED_4 0x00000004LL
#define APFS_FS_ONEKEY 0x00000008LL
#define APFS_FS_SPILLEDOVER 0x00000010LL
#define APFS_FS_RUN_SPILLOVER_CLEANER 0x00000020LL
#define APFS_FS_ALWAYS_CHECK_EXTENTREF 0x00000040LL
#define APFS_FS_RESERVED_80 0x00000080LL
#define APFS_FS_RESERVED_100 0x00000100LL

#define APFS_FS_FLAGS_VALID_MASK (APFS_FS_UNENCRYPTED \
| APFS_FS_RESERVED_2 \
| APFS_FS_RESERVED_4 \
| APFS_FS_ONEKEY \
| APFS_FS_SPILLEDOVER \
| APFS_FS_RUN_SPILLOVER_CLEANER \
| APFS_FS_ALWAYS_CHECK_EXTENTREF \
| APFS_FS_RESERVED_80 \
| APFS_FS_RESERVED_100)

#define APFS_FS_CRYPTOFLAGS (APFS_FS_UNENCRYPTED \
| APFS_FS_ONEKEY)

4. Volume Role 的定义

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
#define APFS_VOL_ROLE_NONE 0x0000

#define APFS_VOL_ROLE_SYSTEM 0x0001
#define APFS_VOL_ROLE_USER 0x0002
#define APFS_VOL_ROLE_RECOVERY 0x0004
#define APFS_VOL_ROLE_VM 0x0008
#define APFS_VOL_ROLE_PREBOOT 0x0010
#define APFS_VOL_ROLE_INSTALLER 0x0020

/* macOS 10.15、iOS 13 重新定义了 Volume 角色 */
#define APFS_VOL_ROLE_DATA (1 << APFS_VOLUME_ENUM_SHIFT)
#define APFS_VOL_ROLE_BASEBAND (2 << APFS_VOLUME_ENUM_SHIFT)
#define APFS_VOL_ROLE_UPDATE (3 << APFS_VOLUME_ENUM_SHIFT)
#define APFS_VOL_ROLE_XART (4 << APFS_VOLUME_ENUM_SHIFT)
#define APFS_VOL_ROLE_HARDWARE (5 << APFS_VOLUME_ENUM_SHIFT)
#define APFS_VOL_ROLE_BACKUP (6 << APFS_VOLUME_ENUM_SHIFT)
#define APFS_VOL_ROLE_RESERVED_7 (7 << APFS_VOLUME_ENUM_SHIFT)
#define APFS_VOL_ROLE_RESERVED_8 (8 << APFS_VOLUME_ENUM_SHIFT)
#define APFS_VOL_ROLE_ENTERPRISE (9 << APFS_VOLUME_ENUM_SHIFT)
#define APFS_VOL_ROLE_RESERVED_10 (10 << APFS_VOLUME_ENUM_SHIFT)
#define APFS_VOL_ROLE_PRELOGIN (11 << APFS_VOLUME_ENUM_SHIFT)

#define APFS_VOLUME_ENUM_SHIFT 6

参考文献

官方文档

源码