大模型学习笔记之六:Transformer
Transformer 架构于 2017 年在 Attention Is All You Need 论文中提出,因其具有能够有效捕捉长距离的依赖关系的能力,迅速成为自然语言处理(LLM)和计算机视觉(CV)任务的标准架构。
文字数字化、位置向量化、语义关系化、预测概率化
多头注意力机制,就是能力更强的 CNN,其中词向量的维度就是 CNN 的通道,多头对应的就是卷积核
词向量采用了绝对位置的编码信息(基于加法进行矩阵修饰),而注意力机制采用了相对位置的编码信息
最后的 Liner 就是对前面的词向量进行一个线性运算,训练时变换称为计算损失值的形式,推理时变换为独热编码,以判断哪个 Token 的概率最大
位置编码的要求:
- 每个单词的TOken都能包含它的位置信息
- 模型可以看到文字之间的距离
- 模型可看懂并学习到位置编码的规则
QKV就是在token原有客观语义的基础上,增加 context 代表的主观语义(嵌入向量,word embedding)进行修正,例如校准多义词的具体含义
WQ、WK、WV是增加了一些参数,如果没有他们,就是$XX^TT$ 也是可以表达自注意力,但是表达能力弱一点
单头QKV情况下,WV是一个(dmodel,dmodel)的矩阵,为了减少数据量 ,可以将其转化为(dmode,x)乘以(x,dmodl),即降秩+升秩;在多头情况下,WV是 nhead 个(dmodel,dhead=dmodel/nhead)的矩阵,然后连接起来与WO(dhead,dmodel)相乘,最终得到输出矩阵(ctx-lenght,dmodel)。上述两个方法在数学上是等价的。
一、概述
Transformer 总体架构可分为四个部分:输入、输出、编码器、解码器。
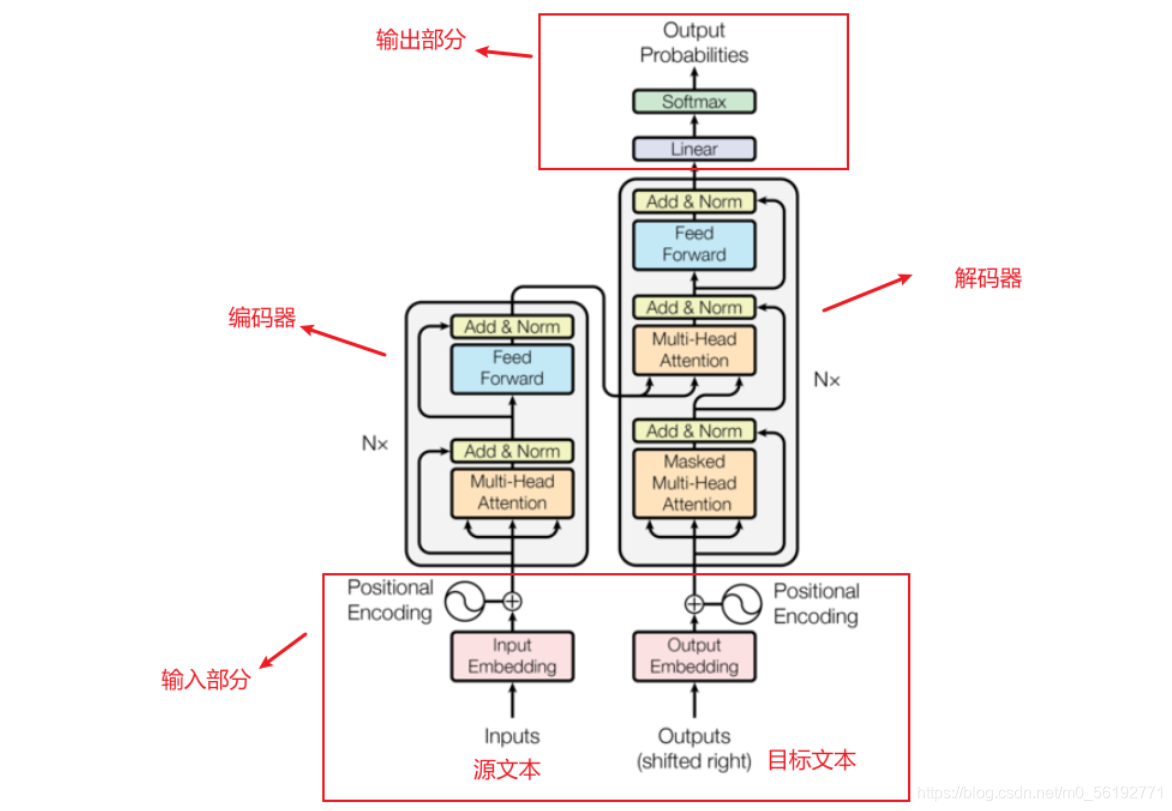
- 输入部分:
- 源文本嵌入层(Inputs Embedding),及其位置编码器(Positional Encoding)
- 目标文本嵌入层(Outputs Embedding),及其位置编码器(Positional Encoding)
- 输出部分:
- 线性层
- softmax层
- 编码器部分:
- 由 N 个编码器层堆叠而成,每个编码器层由 2 个子层连接结构组成
- 第一个子层连接结构包括:一个多头自注意力子层,规范化层,一个残差连接
- 第二个子层连接结构包括:一个前馈全连接子层,规范化层,一个残差连接
- 解码器部分:
- 由 N 个解码器层堆叠而成,每个解码器层由 3 个子层连接结构组成
- 第一个子层连接结构包括:一个Masked多头自注意力子层,规范化层,一个残差连接
- 第二个子层连接结构包括:一个多头注意力子层(不是自注意力),规范化层,一个残差连接
- 第三个子层连接结构包括:一个前馈全连接子层,规范化层,一个残差连接
尽管存在许多堆叠的技术组件,但基本构成就是几种:文本嵌入组件+位置编码器、多头注意力组件、前馈全连接组件、残差组件、规范化组件。
二、Position Embedding - 位置嵌入
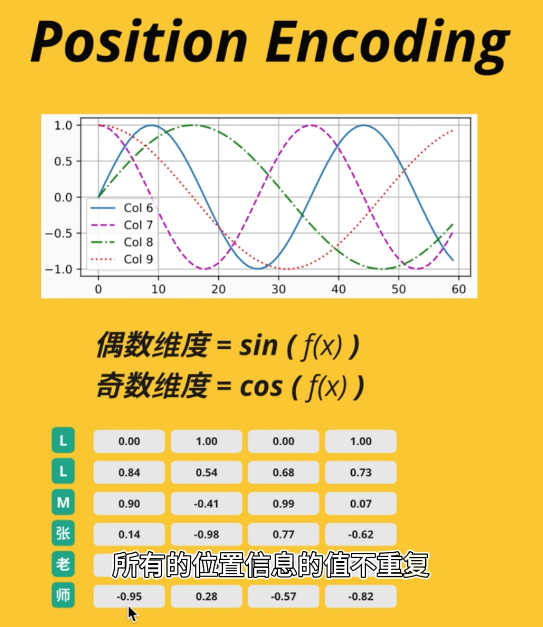
对于 Inputs 和 Outputs 的输入序列来说,仅仅完成词向量的 tokenlized 是不够的(例如“温州的气温是多少度”,两个“温”字的词向量完全相同,但其实际含义完全不同),因此我们需要为词向量添加位置信息。
一般来说,位置编码与嵌入具有相同的维数模型,Transformer 建议采用“矩阵加法”实现,数值则使用了不同频率的正弦和余弦函数,数学表示为:
$$ \begin{align*}
PE_{(pos,2i)} &= sin(pos/10000^{2i/d_{model}}) \\
PE_{(pos,2i+1)} &= cos(pos/10000^{2i/d_{model}})
\end{align*}
$$
其中,$pos$ 定义了位置,$i$ 定义了维度。
三、Multi-Head Attention - 多头注意力
在传统的循环神经网络(RNN)和长短期记忆网络(LSTM)中,处理长距离依赖可能非常困难,因为信息需要通过许多时间步长传递。自注意力机制可以直接捕捉序列中任意两个位置之间的依赖关系,无论它们之间的距离有多远,因此成为 Transformer 最关键的技术改进点!!!
1. 数学定义
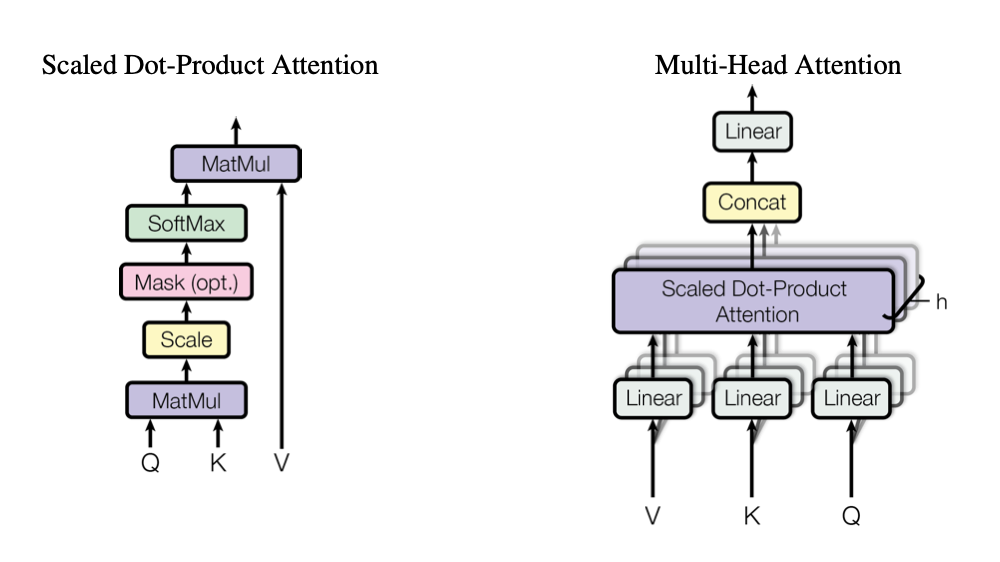
最基础的注意力结构是 Scaled Dot-Product Attention(缩放点积注意力,即单头注意力),数学表达为:
$$Attention(Q,K,V) = softmax(\frac {QK^T}{\sqrt {d_k}})V$$
其中:$\sqrt {d_k}$ 代表了 Scale(缩放),Softmax 就是概率的归一化,此外有可能需要采用 Mask(掩码)。
Multi-Head Attention(多头注意力)是 Scaled Dot-Product Attention 的扩展,数学表达为: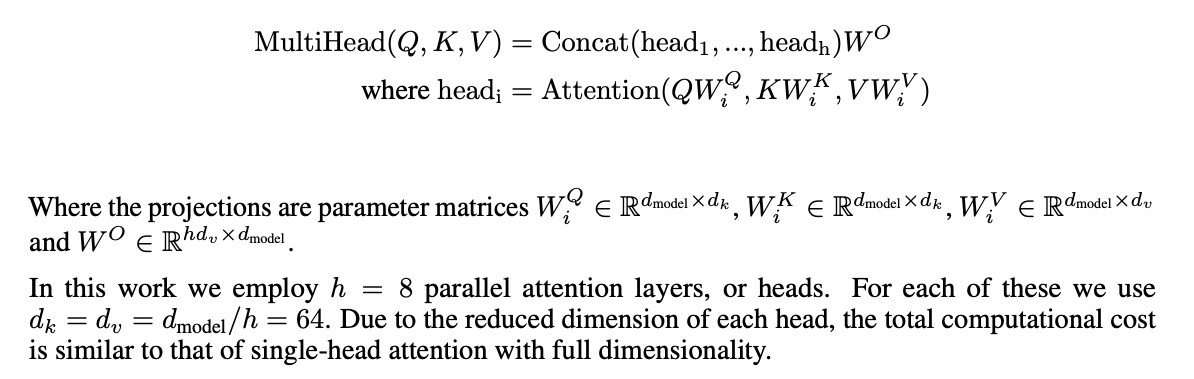
相比单头注意力机制,多头注意力机制(Multi-Head Attention)具有以下优势:
- 多头注意力允许模型在多个不同的表示子空间(分别关注输入序列的不同方面,例如,一个头可能关注句法信息,而另一个头可能关注语义信息)中并行地捕获信息,这增加了模型的表示能力,使其能够同时学习到输入数据的多种特征。
- 多头注意力的计算是高度并行的,这使得模型可以高效地利用 GPU 进行快速训练。
- 多头注意力可以帮助模型在面对不完整或嘈杂的数据时更加鲁棒,因为不同的头可以捕捉到不同的信息,从而减少对单一特征的依赖,同时也有助于提高模型的泛化能力
- 调整头的数量可以控制模型的复杂性和容量。更多的头可以提供更细粒度的分析,但也增加了计算成本。
2. 具体实现
观察上面的 Transformer 结构图,可以发现 3 个不同的多头注意力子层:
- encoder-decoder cross-attention:模仿了机器翻译的交叉注意力机制,Query 来自于解码器的前一层,Key 和 Value 来自于编码器的输出。注意输入顺序是V、K、Q!
- encoder self-attention:标准的自注意力机制,Q、K、V 都来自于编码器的前一层输出。
- decoder masked self-attention:带掩码的自注意力机制,以确保解码器的 auto-regressive 自回归特性(即在生成每个位置时,只能看到它之前的位置,而不能“看到”未来的位置)。实现方法是将矩阵对角线以上部分的所有值设为 $-\infty$
3. 物理意义
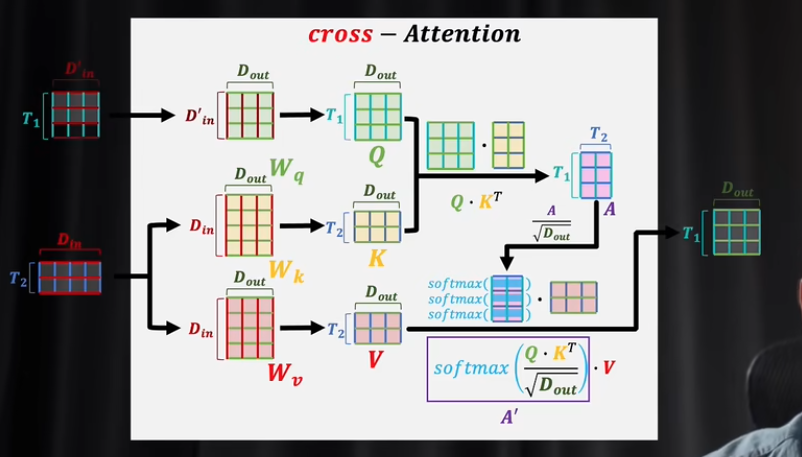
- 词向量已经提供了基于字典表的、单个 token 的客观语义,自注意力机制的目的是提供基于当前上下文的、token 之间的主观语义,并据此对输入向量进行修正。
- 与基于直线的线形变换相比,矩阵二次型实际上是基于圆锥曲线的高维变换,因此有着更强的表达能力。
$$ A = X \cdot W_Q \cdot [X \cdot W_K]^T = X \cdot [W_Q \cdot W_K^T] \cdot X^T = X \cdot W_A \cdot X^T $$ - Q 表示查询向量,K 表示关键字向量,V 表示值向量。可以认为,$Q$ 和 $K$ 分别负责设定语义和表达语义。
换个角度看,就是: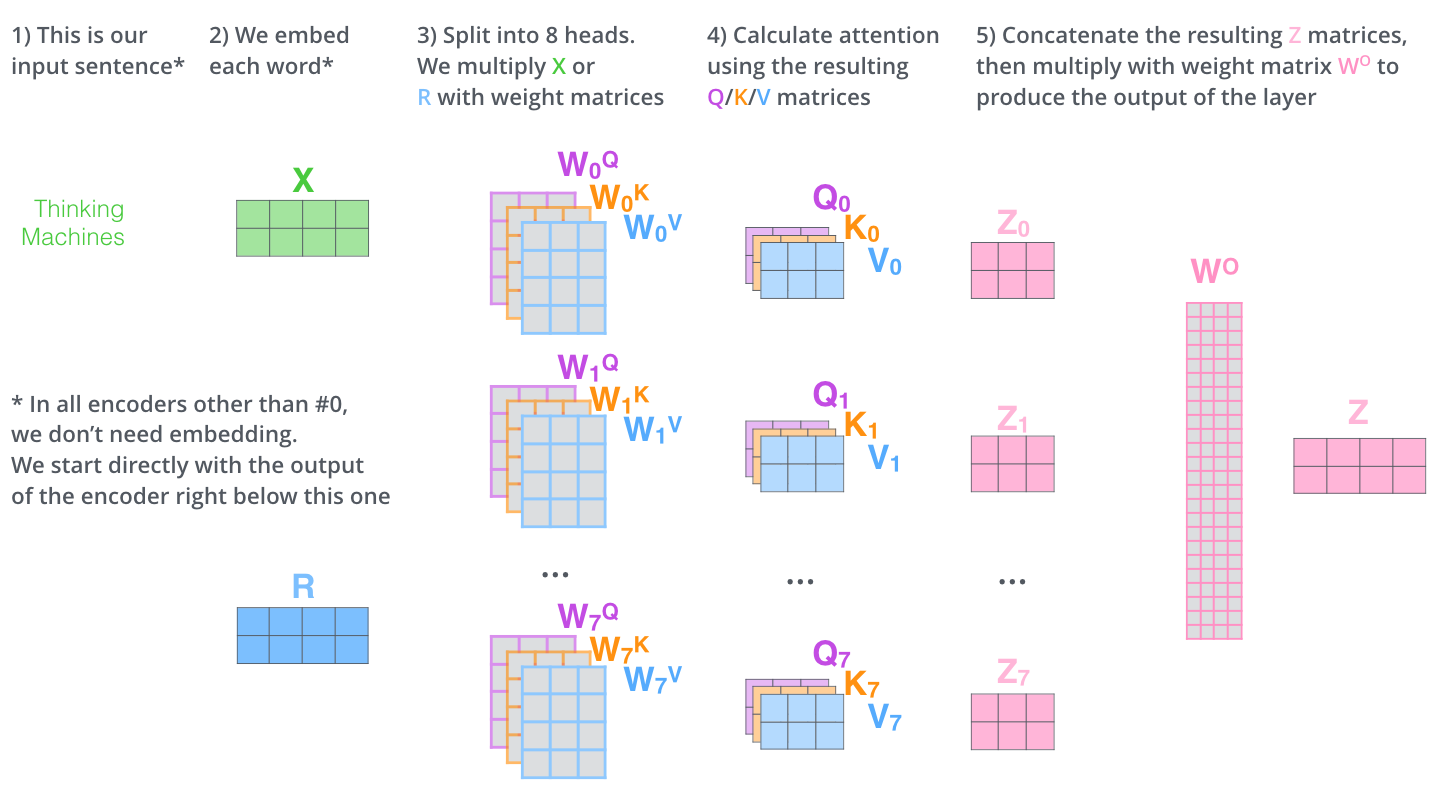
4. 后续改进
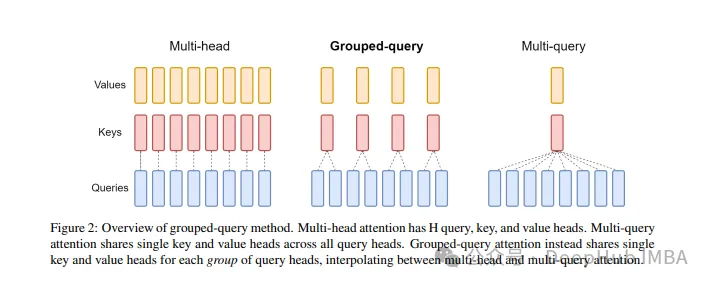
MHA(Multi-head Attention)是标准的多头注意力机制,包含 H 个Query、Key 和 Value 矩阵。所有注意力头的 Key 和 Value 矩阵权重不共享。
MQA(Multi-Query Attention,多查询注意力)是 19 年提出的一种 Attention 机制,其能够在保证模型效果的同时加快 decoder 生成 token 的速度。MQA 是将 head 中的 key 和 value 矩阵抽出来单独存为一份共享参数,而 query 则是依旧保留在原来的 head 中,每个 head 有一份自己独有的 query 参数。
GQA(Grouped-Query Attentio,分组查询注意力)是一种针对 Transformer 模型中 Multi-head Attention 的改进方法,旨在提高模型的运算速度,同时保持预测质量。在标准的Multi-head Attention中,每个注意力头都是独立计算的,这导致了计算和存储需求较高。分组查询注意力通过将查询头分组,让每组共享一个键头和值头,从而减少计算和存储需求。
MQA 和 MHA 主要是在计算 K 和 V 的过程中有计算量的差异,由于训练阶段由于数据是并行的,这种差异整体不明显,而在推理阶段,在 memery cache的基础上,MQA 的推理速度有明显提升,同时也更省内存。
四、Feed Forward Network - 前馈网络
在 Transformer 模型中,每层编码器和解码器都包含一个前馈网络(Feed-Forward Network,FFN),负责在注意力机制的基础上进一步提取特征,增加模型的表达能力。
$$ FFN(x) = \max(0,xW_1+b_1)W_2+b_2$$
前馈网络包含两个线性变换(也称为全连接层或线性层),不同层使用不同的参数。尽管每个位置使用的线性变换形式相同,但是不同层之间的参数是不同的。这意味着每一层都有自己的权重矩阵和偏置项。
这种结构也可以被看作是两次具有核大小为 1 的卷积操作。这里的“卷积”是指在输入序列上应用线性滤波器,但由于核大小为1,它实际上等同于全连接层。
输入和输出的维度都是 $d_{model}$,中间层的维度是 $d_{ff}$(一般设定为 $d_{model}$ 的 4 倍),激活函数建议使用 ReLU。
五、其他组件
2. 规范化组件
3. 残差连接组件
附录一:Gemma 7B 对比分析
以 LLaMA-2 7B 为例,分析其配置文件
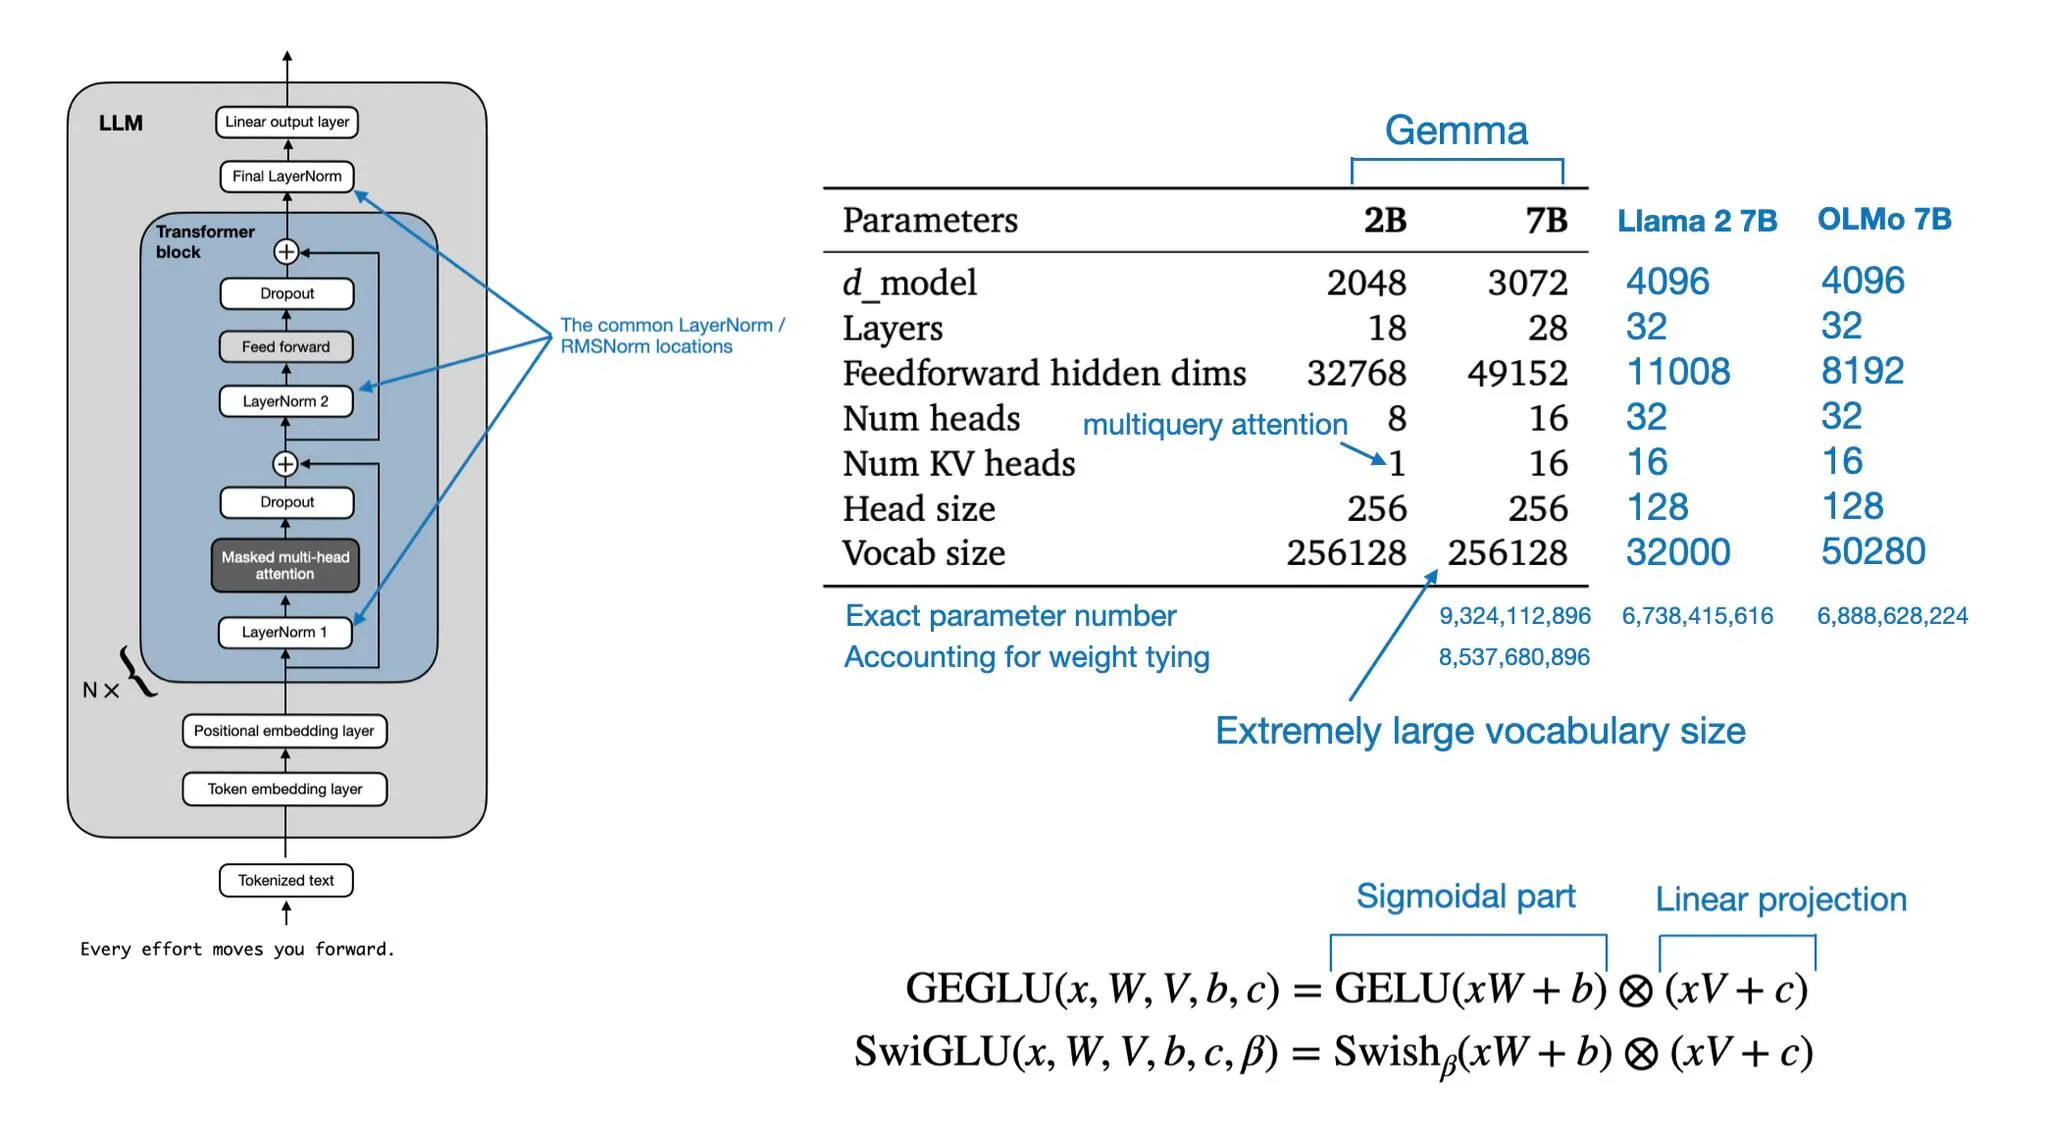
与最近大语言模型的研究趋势一致,我们的网络也基于 Transformer 架构(Vaswani 等,2017)。 但做了很多改进,也借鉴了其他模型(例如 PaLM)中的一些技巧。
2.2.1 改进
以下是与原始架构的主要差异,
预归一化(Pre-normalization):受 GPT3 启发
为了提高训练稳定性,我们对每个 Transformer sub-layer 的输入进行归一化,而不是对输出进行归一化。 这里使用由 Zhang 和 Sennrich(2019)提出的 RMSNorm 归一化函数。
SwiGLU 激活函数:受 PaLM 启发
用 SwiGLU 激活函数替换 ReLU 非线性,该函数由 Shazeer(2020)提出,目的是提升性能。 但我们使用的维度是 2/3 * 4d,而不是 PaLM 中的 4d。
旋转嵌入(Rotary Embeddings):受 GPTNeo 启发
去掉了绝对位置嵌入(absolute positional embeddings),并在每个网络层中添加旋转位置嵌入(rotary positional embeddings,RoPE)。 RoPE 由 Su 等(2021)提出。
1 | # 词汇表的大小:The number of tokens in the vocabulary. |
- 词汇表的容量:256K
- 隐藏层的数量:28
- 隐藏层的维度:3072
- 自注意力 head 的数量:16
三、GPT-3 模型的参数构成分析
GPT-3 是一个由 1750 亿个参数组成的语言模型,其 Transformer 架构仅包含解码器部分,预训练时将生成并固化所有 175B 个模型参数。
为了定义 GPT-3 模型的结构,其核心的超参数(无法通过训练调整的参数)包括:
- 词向量维度:$d_{model}=12288$,词汇表容量:$n_{vocab}=50257$
- 解码器层数:$n_{layers}=96$
- 注意力头数:$n_{heads}=96$;相应得出查询向量维度:$d_k = d_{model} \div n_{heads} = 12288 / 96 =128$,而且仅有解码器部分时,$d_v=d_k$
- 前馈神经元数量:$n_{neurons}=49152$(经验表明,隐藏层神经元数量通常设置为输入层的 4 倍)
- 上下文长度:$n_{ctx}=2048$
- 批次大小:Batch Size = 3.2M
- 学习率:Learning Rate = $0.6 \times 10^{-4}$
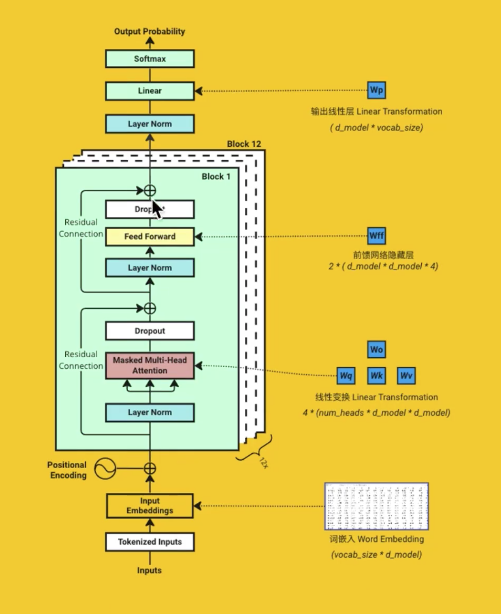
Inputs 作为原始语言输入,例如“大模型的三个要素是”包含了 9 个 token,是一个用户输入的、长度为 $length_{ctx}$ 的向量(当然 $length_{ctx} \leqslant n_{ctx}$),后续就是其与包含大模型 175B 参数的若干个矩阵进行计算:
1 个 $W_E(n_{vocab},d_{model})$:词向量嵌入矩阵,存储了所有词汇表及其维度信息。
对用户输入进行向量化处理(Input Embedding),并嵌入位置信息(Positional Embedding)。
输出一个形状为$(length_{ctx},d_{model})$ 的矩阵 $X$ 作为下一阶段的输入。96 个多头注意力子层:包含了 96 个注意力头,每个注意力头包含 3 个矩阵
- $W_Q(d_{model},d_k)$:$Q=XW_Q$
- $W_K(d_{model},d_k)$:$K=XW_K$,
计算自注意力矩阵$A(length_{ctx},length_{ctx}) = QK^T$,softmax 归一化处理得到$A’$ - $W_V(d_{model},d_v)$:也称 Value Down 矩阵,$V=XW_V$
对于每个单头,分别计算 $O(length_{ctx},d_v)=A’V$
最后,$W_O(d_{model},d_{model})$:也称 Value UP 矩阵,目的是还原为 $d_{model}$ 维度
把全部单头拼接起来形成$O’$,然后计算 $O’W_O$ 得到 $X’(length_{ctx},d_{model})$96 个前馈全联接子层:包含了 2 次线性变换,即图中的 Wff
- $W_{Up}(d_{model},n_{neurons})$:$Up=XW_{Up}$,维度从 $d_{model}$ 提升到 $d_{neurons}$
- $W_{Down}(n_{neurons},d_{model})$:$X’’=Down=UpW_{Down}$,维度从 $d_{neurons}$ 还原到 $d_{model}$
1 个Unembedding Matrix $(n_{model},d_{vocab})$:即图中的 Wp/WU,与WE相似,但是行列顺序相反,目的是基于词向量维度,线性变换为词汇表,然后 Softmax 计算出每个词的概率,并选择概率最大的单词作为输出。
对于每一个可能的输出特征,在词典中对应的每一个文字,都有一个dmodel维度的权重向量
汇总参数数量如下图,其中前馈全联接子层占比66%,自注意力子层占比33%,词汇表不足1%。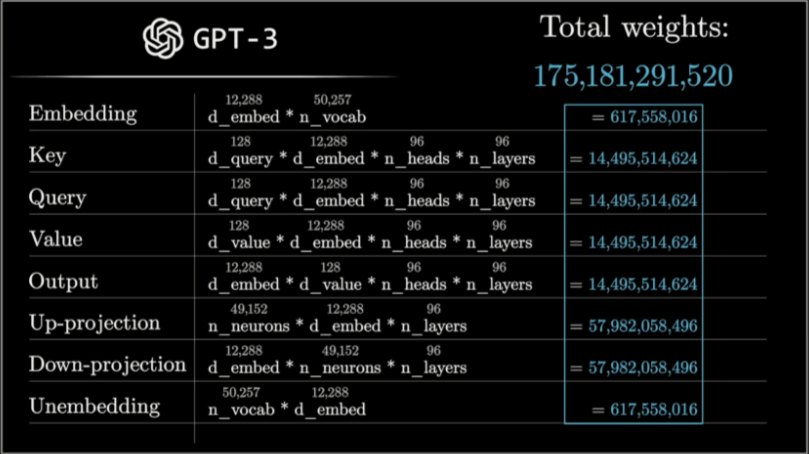
1. Word Embedding Matrix()
2. QKV 矩阵
3. Feed Forward
输入数据为:
- $T_1$:基准输入数据,形状为 $(length_{ctx1}, d_{model})$
- $T_2$:对照输入数据,形状为 $(length_{ctx2}, d_{model})$
- 如果是自注意力机制,则 $T_2=T_1$
注意力机制的层数是 $n_{layers}$,如果是单头注意力机制:
- 1 个 $W_q$:Query 权重矩阵,形状为$(length_{ctx1}, d_{model})$
- 1 个 $W_k$:Key 权重矩阵,形状为$(length_{ctx2}, d_{model})$
- 1 个 $W_v$:Value 权重矩阵,形状为$(length_{ctx2}, d_{model})$
- 中间结果 $A$ 的形状为 $(length_{ctx1}, length_{ctx2})$
TODO: 3Blue1Brown 视频视频中说 Value 是 12288 * 12288 的矩阵,分解为 12288 * 128 乘以 128 * 12288 的矩阵乘法,参数分别是 value 和 output,与我的理解有差异!!!
如果是多头注意力机制,则有$d_{head} = d_{model} \div n_{heads}$(也称为 d_query),相应的:
- $n_{heads}$ 个 $W_q$:Query 权重矩阵,形状为$(length_{ctx1}, d_{head})$
- $n_{heads}$ 个 $W_k$:Key 权重矩阵,形状为$(length_{ctx2}, d_{head})$
- $n_{heads}$ 个 $W_v$:Value 权重矩阵,形状为$(length_{ctx2}, d_{head})$
输出数据的形状为 $(length_{ctx1}, d_{model})$,也就是与输入数据的形状完全系统。
GPT-3 的前馈全联接子层包含 2 个串联的线性组件,分别是 Up-projection 和 Down—projection,主要参数是:
- Up-projection:输出数据的形状为 $(length_{ctx1}, d_{model})$,包含 $n_{neurons}$ 个神经元,输出数据的形状为 $(length_{ctx1}, n_{neurons})$
- Down—projection:输入就是 Up-projection 的输出,包含 $d_{model}$ 个神经元,输出数据的形状为 $(length_{ctx1}, d_{model})$
附录一:残差网络(ResNet)
Residual Network(残差网络,ResNet)是一种深度卷积神经网络(CNN)架构,由 Kaiming He(何凯明)在 2015 年提出,核心思想是通过引入“残差学习”(residual learning)来解决深度神经网络训练中的退化问题(degradation problem)。
在传统的深度神经网络中,随着网络层数的增加,理论上网络的表示能力应该更强,但实际上,过深的网络往往难以训练,性能反而不如层数较少的网络。这种现象被称为“退化问题”,即随着网络深度的增加,网络的准确率不再提升,甚至下降。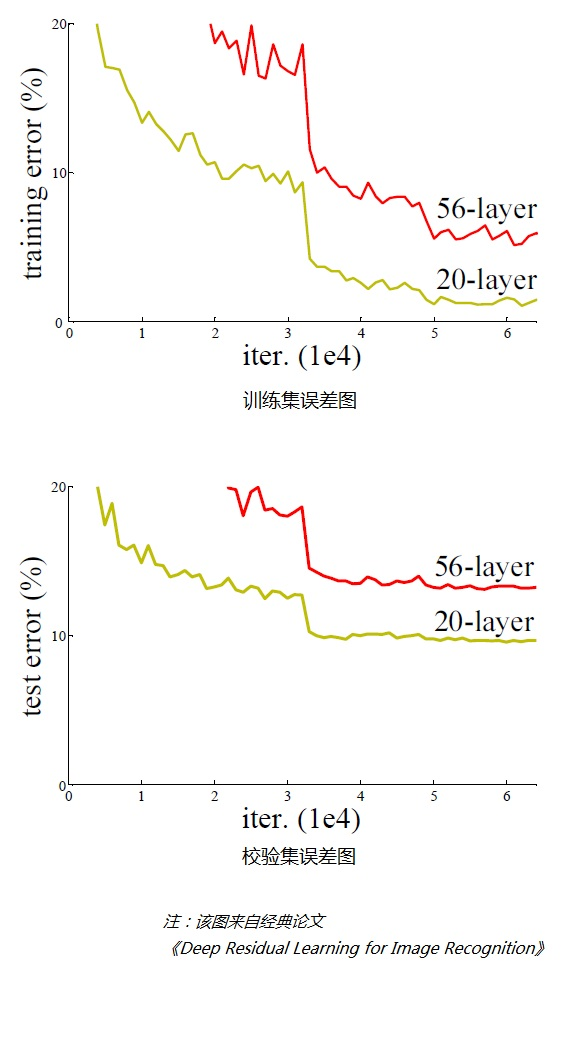
ResNet通过引入“跳跃连接”(skip connections)或“捷径连接”(shortcut connections)来解决这个问题。在ResNet中,输入不仅传递给当前层,还直接传递到后面的层,跳过一些中间层。这样,后面的层可以直接学习到输入与输出之间的残差(即差异),而不是学习到未处理的输入。这种设计允许网络学习到恒等映射(identity mapping),即输出与输入相同,从而使得网络可以通过更简单的路径来学习到正确的映射关系。
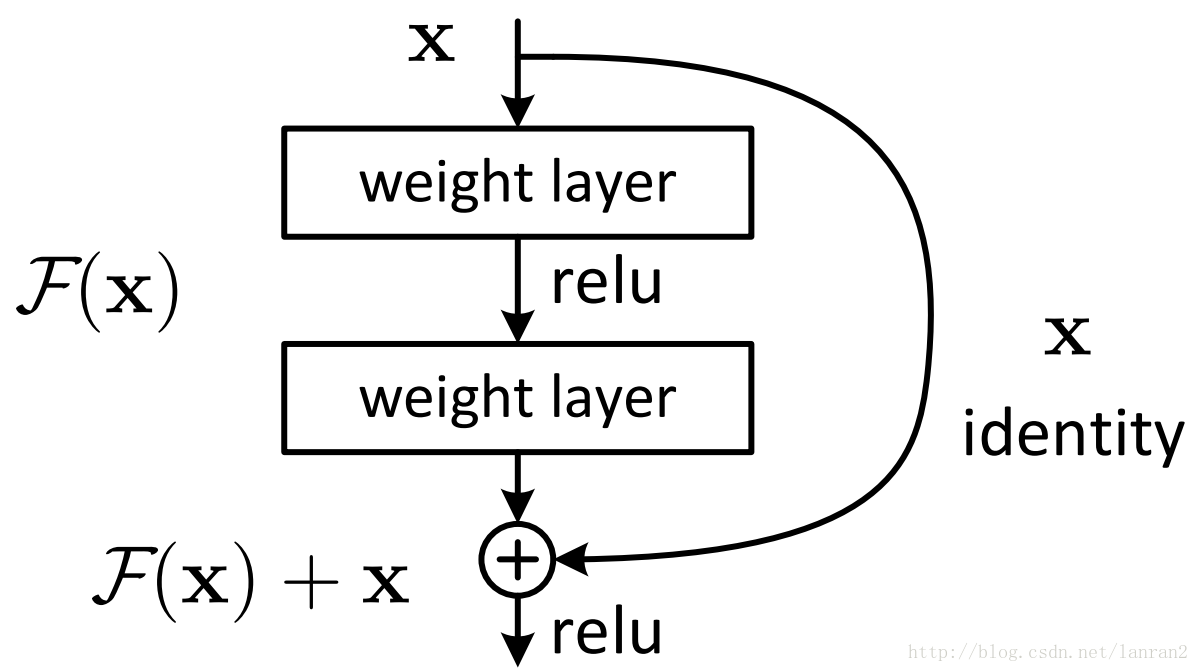
在 Transformer 模型中,残差网络的使用主要是为了解决自注意力机制(self-attention)带来的问题。Transformer模型完全基于注意力机制,没有卷积层,但其结构本质上也是深度网络。在 Transformer 中,每个编码器(encoder)和解码器(decoder)层都包含自注意力和前馈网络,这些层的参数量非常大,网络深度也很容易变得很深。使用残差连接可以帮助Transformer模型更有效地训练深层网络。在 Transformer 的自注意力层中,输入通过自注意力和前馈网络后,与原始输入相加,形成残差连接。这种设计使得网络即使在增加更多层数时,也能保持较好的性能,避免了退化问题。
参考https://zh.d2l.ai/chapter_convolutional-modern/resnet.html
1 | import torch |
参考文献
视频教材
技术解读
- Transformer 高级讲解 - Jay Alammar
- 想要更好地理解大模型架构?从计算参数量快速入手
- Self-Attention:Learning QKV step by step
- Transformer中的位置编码
- Transformer架构解析
- 深入解析 LLaMA 如何改进 Transformer 的底层结构