信息论基础 - 信息熵
熵(Entropy)最早是物理学的概念,用于表示一个热力学系统的无序程度。1948年,美国数学家克劳德·香农发表论文《通信的数学理论》(A Mathematical Theory of Communication),将统计物理中熵的概念引申到信道通信的过程中,从而奠定了信息论的基础。
信息论回答了通信理论的两个基本问题:一是数据压缩的极限(答案:熵$H$);二是通信传输速率的临界(答案:信道容量$C$)
- 香农第一定理:无失真信源编码定理,或变长码信源编码定理
将原始信源符号转化为新的码符号,使码符号尽量服从等概分布,从而每个码符号所携带的信息量达到最大,进而可以用尽量少的码符号传输信源信息。即信源的信息熵 $H_r(S)$ 是无失真信源压缩的极限值。 - 香农第二定理:有噪信道编码定理
当信道的信息传输率不超过信道容量($R<C$)时,采用合适的信道编码方法可以实现任意高的传输可靠性,但若信息传输率超过了信道容量($R>C$),就不可能实现可靠的传输。 - 香农第三定理:保真度准则下的有失真信源编码定理,或有损信源编码定理
只要码长足够长,总可以找到一种信源编码,使编码后的信息传输率 $R’$ 略大于率失真函数 $R(D)$,而码的平均失真度不大于给定的允许失真度,即$D’ \leq D$
样本空间是概率论的基础,包含了所有可能的实验结果或观察结果。
本文使用 $:=$ 表示“定义”,区别与一般意义的“相等”,或“赋值”
一、信息熵的定义
1. 自信息(Self-information)
自信息是一个事件的信息量的度量,基本思想是概率越小,事件蕴含的信息量越大,定义为:
$$I(x) := -\log P_X(x)$$
举个例子,假定北京天气是晴天的概率是 80%,下雨的概率是 20%,那么:
- 天气预报说“今天是晴天”,提供的信息量就是 $-\log 0.8=0.322$,说明这是一个大概率事件
- 天气预报说“今天是雨天”,提供的信息量就是 $-\log 0.2=2.322$,说明这是一个小概率事件
一个 100% 概率发生的事件,其信息量就是 $-\log 1=0$;“国足踢进了世界杯“这种非常小概率的事件,一定有很多曲折的内幕,其蕴含的信息量就非常大;最极端的,如果发生概率为 0,那么一旦发生就意味着我们发现一个从不知道的新世界,信息量就是无穷大了!
满足如下性质:
- 非负性:$I(x) \geq 0 $
- 单调(递减)性:如果 $P(a) < P(b)$,则$I(a) > I(b)$
- 独立可加性:当事件 $a$ 和 $b$ 相互独立时,$I(a,b) = I(a) + I(b)$
2. 信息熵(Information Entropy)
定义为一个样本空间上所有随机事件(随机变量是离散的)的自信息的期望,熵在物理意义上是平均意义下对随机事件不确定性/信息量的度量,计算机意义上是平均意义上对随机变量的编码长度。
换句话说,事件的概率分布和每个事件的信息量构成了一个随机变量,这个随机变量的均值(即期望),就是这个分布产生的信息量的平均值,即为信息熵。
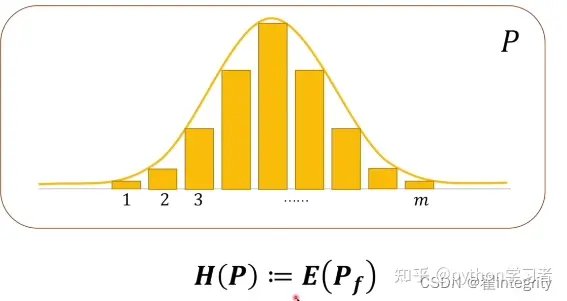
如果样本空间是离散变量,也称为香农熵(Shannon Entropy),定义为:
$$H(x) := E_X[I(X)] = - \sum_{x \in X} p(x) \log {p(x)}$$
香农熵满足以下性质:
- 非负性:$H(X) \geq 0$
- 概率密度函数为平均分布时,$H(X)$ 取得最大值
信息论的物理意义:根据信息的概率分布对信息编码所需要的最短平均编码长度。
还是以天气预报为例,考虑几种不同的概率分布:
- 如果晴天概率80%,雨天概率20%,信息熵为 $-(0.8 \times log_{2}0.8 + 0.2 \times log_{2}0.2) =0.7219$
- 如果晴天和雨天的概率都是50%,信息熵为 $-(0.5 \times log_{2}0.5 + 0.5 \times log_{2}0.5) = 1$
- 再搞复杂一点,如果有四种天气,分别是晴天、阴天、小雨和大雨,其发生概率都是25%,则信息熵为 $-(0.25 \times log_{2}0.25 + 0.25 \times log_{2}0.25 + 0.25 \times log_{2}0.25 + 0.25 \times log_{2}0.25 = 2$
对于一个给定的(预测)概率分布,信息熵是对可能产生的信息量的期望,代表着对系统不确定性的评估数值。在上面的例子中,预测二的概率分布比预测一更平均,因此不确定性更强;与预测二相比,预测三同样是平均分布,但天气的状态数量更多,也说明其不确定性更高。
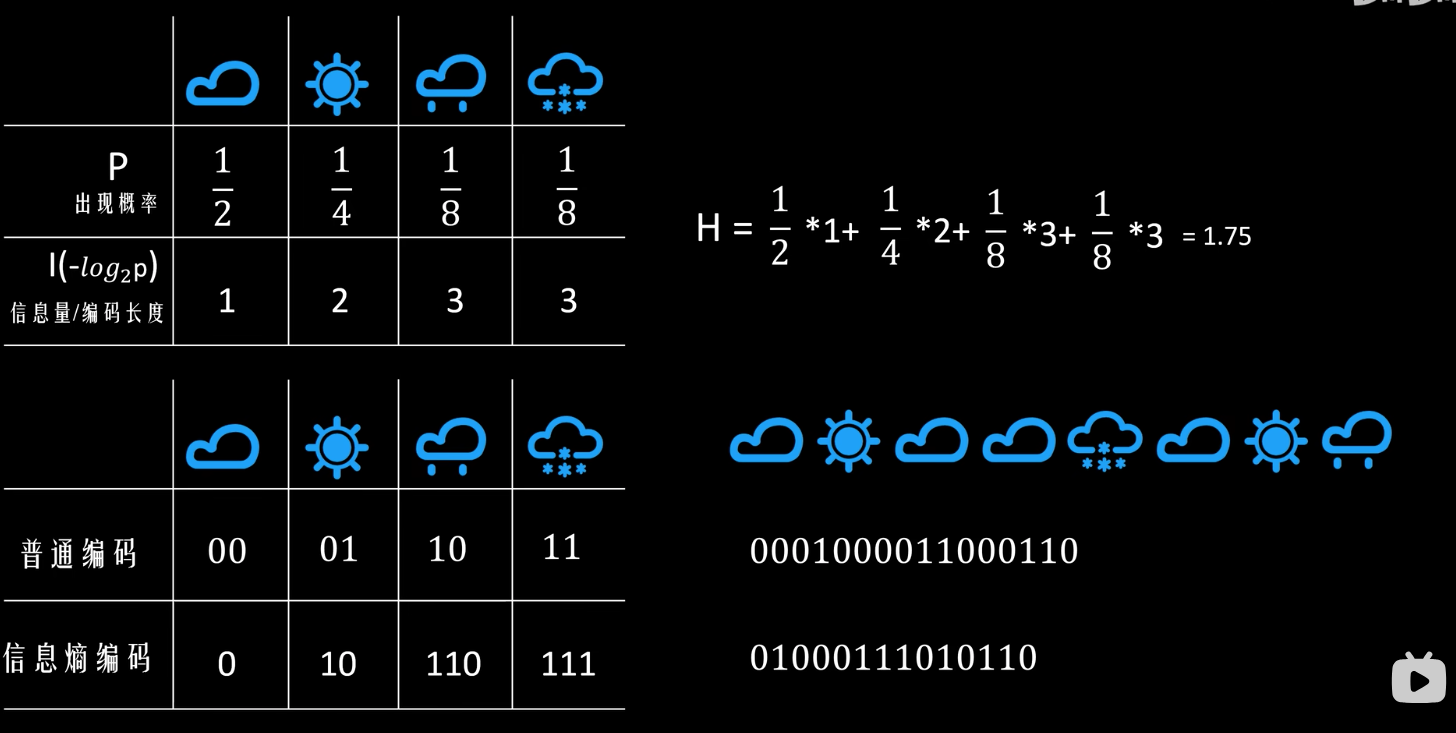
预测三的 4 种天气为均匀分布,其信息熵为 2,意味着最少需要 2 位编码表示;
而上图的不均匀分布,最优编码是 0、10、110、111,平均编码长度为 1.75,与信息熵相等。
$ 1 \times 0.5+2 \times 0.25+3 \times 0.125+3 \times 0.125=1.75 $
3. 差分熵(Differential Entropy)
香农熵是基于离散变量的,如果拓展到连续变量,称为差分熵(Differential Entropy),定义为:
$$h(x) := -\int p(x) \log p(x)dx$$
微分熵满足以下性质:
- 概率密度函数为正态(高斯)分布时,$h(x)$取得最大值。
- 不满足非负性。
差分熵可以是正的,也可以是负的,甚至是未定义的。例如,柯西分布(Cauchy distribution)就是一个具有未定义的差分熵的分布,因为它有一个尖峰在中心,并且尾部衰减得非常慢,导致其概率密度函数在中心附近为零,但在整个实数线上积分不为零。请参见 Differential entropy - Wiki。
二、联合熵、条件熵和互信息
上面定义了一个随机变量的熵,现在推广到两个或多个随机变量。
1. 联合熵(Joint Entropy)
联合熵是衡量一组变量的不确定性的指标,显然其与联合概率有关。数学定义为:
$$ H(X,Y) := E[I(X,Y)] = -\sum_{x \in X} \sum_{y \in Y} p(x,y) \log {p(x,y)}$$
满足以下性质:
- 如果 $X$ 与 $Y$ 是独立的,$H(X, Y) = H(X) + H(Y)$ , 并推广到 N 个变量
信息论的物理意义:观察一个包含多个随机变量的随机系统获得的信息量。
2. 条件熵(Conditional Entropy)
在给定 $Y = \{y_1, y_2, y_3 … y_n\}$ 发生的前提下,求事件 $X = \{x_1, x_2, x_3 … x_m\}$ 的熵,称为 $X$ 的条件熵,用来衡量 $Y$ 发生的不确定性, 此时用 $H(X|Y)$ 来表示 $X$ 的条件。数学定义是:
$$ H(X|Y) := -\sum_{x \in X} \sum_{y \in Y} p(x,y) \log p(x|y) = -\sum_{x \in X} \sum_{y \in Y} p(x,y) \log \frac {p(x,y)}{p(x)} $$
满足以下性质:
- 链式规则:$H(Y|X) = H(X,Y) - H(X)$
- 贝叶斯规则:$H(Y|X) = H(X|Y) + H(Y) - H(X)$
信息论的物理意义:在得知某一确定信息的基础上,获取另外一个信息时所获得的信息量。
3. 互信息(Mutual Information)
定义:已知 $I(x)$是 $x$ 事件所含有的信息量,$I(x|y)$ 是 $x$ 事件在给定 $y$ 事件发生后的信息量,那么两者的差值就是 $y$ 事件带给 $x$ 事件的信息量(增益):
$$ I(X;Y) := I(X) - I(X|Y) = -\sum_{x \in X} \sum_{y \in Y} p(x,y) \log \frac {p(x,y)}{p(x)p(y)} $$
互信息是用来衡量随机变量之间的依赖性的度量,满足如下性质:
- 对称性:$I(x;y) = I(y;x)$
- 当事件 $x$ 和 $y$ 相互独立时,$I(x;y) = 0$;即 $y$ 无法给 $x$ 带来信息(增益)
- 可正可负
- $I(x;y) \leq \frac {I(x)}{I(y)}$
信息论的物理意义:互信息(信息增益) = 信息熵 — 条件熵
4. 熵和互信息的关系
对于随机变量 $X$, $Y$,它们的熵、联合熵、条件熵以及互信息之间的关系是: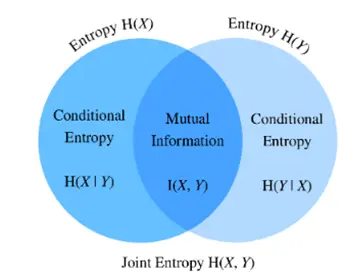
- $I(X;Y) = H(X) - H(X|Y) = H(Y) - H(Y|X)$
- $I(X;Y) = H(X) + H(Y) - H(X,Y)$
- $I(X;Y) = I(Y;X)$,满足对称性,因此不能用于确定信息流的方向
- $I(X;X) = H(X)$,单一变量不能给自身带来新的信息
互信息就是信息增益,用于衡量随机变量之间相互依赖程度的度量。例如,构建决策树时选择某个特征变量,导致分类模型(另一个变量)的不确定性减少,也就是带来了新的信息,减少的越多说明这个特征越重要。
反之,如果 $X$ 和 $Y$ 互相独立,即两者之间互相不提供任何信息,则他们的互信息为 0。
三、相对熵 - 不同概率分布的比较
衡量两个概率分布之间的差异(不确定性),主要有 KL 散度、JS 散度、交叉熵和 Wasserstein 距离等指标。
1. KL散度(Kullback-Leibler Divergence,或 相对熵 - Relative Entropy)
若 $P$,$Q$ 定义在同一个概率空间的不同测度,那么 KL Divergence 定义为:
$$D_{KL}(P||Q) := E_P[\log \frac {p(x)}{q(x)}] = \sum_{i=1}^n p(x_i)log(\frac {p(x_i)}{q(x_i)})$$
其中,为了保证连续性,定义 $0 \log \frac{0}{0} = 0$,$0 \log \frac{0}{q} = 0$。
以下图为例,黄色柱体是目标分布 $P(x)$,蓝色柱体是评价分布 $Q(x)$,棕色是两者的重叠部分,而本色区域就两者之间的“距离”,再基于 $P(x)$ 的概率分布“累计”得到期望值,这就是 KL 散度的直观解释。
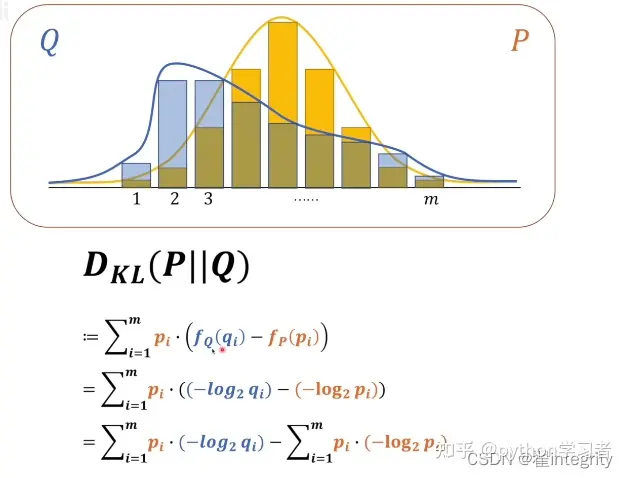
KL散度又称为相对熵,信息散度,信息增益。满足以下性质:
- 非对称性:$ D_{KL}(P \| Q) \neq D_{KL}(Q \Vert P) $。KL 散度不是严格意义的 metric 指标。
- 非负性:$ D_{KL}(P || Q) \geqslant 0 $,当且仅当 $P(x) = Q(x) $ 时等号成立。根据吉布斯不等式可以证明
- $D_{KL}(P||Q) = H(P,Q) - H(P)$,即:相对熵 = 交叉熵 - P的信息熵
信息论的物理意义:使用错误分布 $Q$ 来表示真实分布 $P$ 中的样本,所使用编码的平均长度的增量
互信息是用于衡量两个随机变量之间的依赖性的度量,其实也是一种相对熵,只是它衡量的并非随机变量 $p$ 和 $q$,而是他们的联合分布 $p(x,y)$ 和边缘分布乘积 $p(x)p(y)$ 的相似程度。
$$ I_{X;Y}(x,y) := I_X(x) - I_{X|Y}(x|y) = \log \frac {P_{X|Y}(x|y)}{P_X(x)} = \log \frac {P_{XY}(xy)}{P_X(x)P_Y(y)}$$
2. 交叉熵(Cross Entropy)
给定两个概率分布 $P$ 和 $Q$,$P$ 相对于 $Q$ 的交叉熵定义为:
$$H(P,Q) := E_P[-\log Q] = -\sum_{x \in X} p(x) \log q(x)$$
还是以 KL散度的图为例,蓝色柱体是评价分布 $Q(x)$,不考虑黄色柱体,直接以目标分布 $P(x)$ 的概率分布“累计”得到期望值,这就是交叉熵的直观解释。这也体现了两者之间的差别就是目标分布 $P(x)$ 的信息熵。
信息论的物理意义:使用错误分布 $Q$ 来表示真实分布 $P$ 中的样本,所使用编码的平均长度
3. JS散度(Jensen-Shannon Divergence)
对于两个概率分布 $P$ 和 $Q$,JS 散度定义为:
$$D_{JS}(P||Q) = \frac{1}{2} D_{KL}(P || M) + \frac{1}{2} D_{KL}(Q || M) $$
其中: $M$ 是 $P$ 和 $Q$ 的几何平均,定义为:$ M(x) = \sqrt{P(x) \cdot Q(x)} $
JS散度是 KL散度的一种对称化形式,满足如下性质:
- 非负性:$D_{JS} \geq 0$,且仅当 $P = Q$ 时为 0
- 对称性:JS 散度是对称的,即 $D_{JS}(P || Q) = D_{JS}(Q || P)$
- 三角不等式:对于任意三个概率分布 $P$,$Q$ 和 $R$,有:$ D_{JS}(P || R) \leq D_{JS}(P || Q) + D_{JS}(Q || R) $
四、应用分析
KL散度可以用来衡量两个概率分布的”距离”。但是KL散度并不是标准意义的度量指标(不满足对称性),即$D_{KL}(p,q) \neq D_{KL}(q,p)$,因此应用KL散度时,必须明确区分哪个是“真实”分布,哪个是“近似(预测)”分布。
通常我们使用的是$D_{KL}(p,q)$(也记作$D_q(p)$),称为正向KL散度(Forward KL),要使其最小的数学表达为:
$$q^* = \arg \min_q D_{KL}(p||q) = \arg \min_q \sum_{x \in X} p(x)\log \frac {p(x)}{q(x)} $$
其优化重点是在$p(x)$较小的位置,$q(x)$应避免为零(将导致对数无穷大),因此其也被称为“zero avoiding”,结果是得到一个较宽的分布,峰值未必突出,但底部比较平坦。
反之,$D_{KL}(q,p)$(也记作$D_p(q)$)称为反向KL散度(Reverse KL),要使其最小的数学表达为:
$$q^* = \arg \min_q D_{KL}(q||p) = \arg \min_q \sum_{x \in X} q(x)\log \frac {q(x)}{p(x)} $$
其优化重点是在$p(x)$为零的位置,$q(x)$应尽量为零(因为分母为零导致对数无穷大,但 $0 \log \frac{0}{0}=0$),因此其也被称为“zero forceing”,结果是得到一个较窄的分布,底部尽量低,这也往往导致峰值更突出。
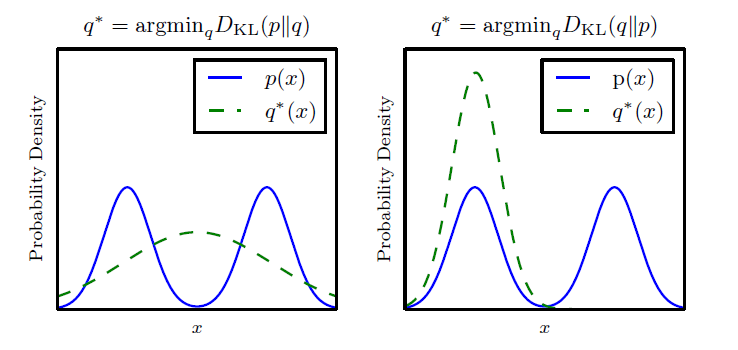
综上所述,正向KL散度的分布偏向一般化,而反向KL散度的分布偏向极端化。从模型泛化的角度看,在损失函数结果相等的情况下,显然正向KL散度更有优势!
此外,在模型的训练阶段通常已经确定了输入数据和标签数据,即真实概率分布P(X)的信息熵是一个常量,此时最小化KL散度与最小化交叉熵效果是一致的,但是优化交叉熵的计算量小于优化KL散度,因此在损失函数的计算中得到广泛应用。
示例
概率分布 $P$ 和 $Q$ 分别定义在同样的样本空间 {0, 1} 上,真实分布 $P$:$P(0) = 0.8, P(1) = 0.2 $
- 对于预测分布$Q1$:$Q(0) = 0.6, Q(1) = 0.4 $,计算交叉熵:
$H(P,Q) =-(P(0) \log Q(0) + P(1) \log Q(1)) =-(0.8 \log0.6 + 0.2 \log0.4) = 0.8540$ - 换一个预测分布$Q2$:$Q(0) = 0.7, Q(1) = 0.3 $,此时交叉熵为:
$H(P,Q) =-(P(0) \log Q(0) + P(1) \log Q(1)) = -(0.8 \log0.7 + 0.1 \log0.3) = 0.7591$ - 如果预测分布等于真实分布,$Q(0) = 0.6, Q(1) = 0.4 $,此时交叉熵:
$H(P,Q) =-(P(0) \log Q(0) + P(1) \log Q(1)) = -(0.8 \log0.8 + 0.2 \log0.2) = 0.7219$ - 进一步,如果预测分布$Q4$:$Q(0) = 0.9, Q(1) = 0.1 $,此时交叉熵为:
$H(P,Q) =-(P(0) \log Q(0) + P(1) \log Q(1)) = -(0.8 \log0.9 + 0.2 \log0.1) = 0.7860$
分析交叉熵的数值:
- $H(P,Q2) < H(P,Q1)$:表明相比$Q1$,$Q2$更接近真实分布;
- $H(P,Q3)$ 是最小值:因为真实分布与其自身的交叉熵就是信息熵,$H(P,P) = H(P)$;
- $H(P,Q4) \approx H(P,Q2)$:表明两者与真实分布的“距离”差不多。而 $H(P,Q4) > H(P,Q3)$是肯定的。
附录一:几个名词解释
Divergence - 散度
Divergence 这个词来源于拉丁语词根 diverge,意为”分叉”或”偏离”。
在数学中,通常指的是向量场中某一点的发散性,即向量从这一点向外散开的程度。
在物理学中,可以指能量或物质的发散,例如在热力学中,热量的发散。
反义词是 convergence ,意为”汇聚”或”趋同”,指的是从不同起点汇聚到一点或趋于一致。
Metric - 度量
在数学中,度量空间(metric space)是具有距离(distance)这一个概念的集合,具体来说,是装配了一个称为度量的函数,用以表示此集合中任两个成员间的距离。历史上是由法国数学家莫里斯·弗雷歇在1906年于其意大利语著作《Sur quelques points du calcul fonctionnel》首次使用。其定义为:
$M$ 为集合,若其装配了函数 $d: M \times M \rightarrow R$,对任意 $x,y,z \in M$ 满足:
- 同一性:$d(x,y) = 0 \Longleftrightarrow x = y$
- 对称性:$d(x,y) = d(y,x)$
- 三角不等式:$d(x,z) \leq d(x,y) + d(y,z)$
则称 $d$ 为定义在 $M$ 上的度量(metric),或是距离函数,且称 $(M,d)$ 为度量空间。
附录二:吉布斯不等式(Gibbs’ Inequality)
吉布斯不等式(Gibbs’ Inequality)是信息论中的一个基本不等式,由 J.W. Gibbs 提出的,表明联合熵(Joint Entropy)不会超过两个随机变量各自熵(Entropy)的和,数学定义是:
对于任意两个随机变量 $X$ 和 $Y$,$H(X, Y) \leq H(X) + H(Y) $
当且仅当随机变量 $X$ 和 $Y$ 相互独立时,等号成立,即 $ H(X, Y) = H(X) + H(Y) $。这是因为如果 $X$ 和 $Y $ 独立,那么知道 $X$ 的信息不会对 $Y$ 的不确定性产生任何影响,反之亦然。
附录三:最大熵思想 (Maximum Entropy Principle)
最大熵的思想是,当你要猜一个概率分布时,如果你对这个分布一无所知,那就猜熵最大的均匀分布;如果你对这个分布知道一些情况,那么,就猜满足这些情况下的熵最大的分布。
换句话说,除了已经确认的信息,不做任何未知假设,直接把所有未知事件当成等概率事件处理。
吴军老师的《数学之美》第 20 章中提到了一个掷骰子的例子可以很好的解释最大熵原理。对于一个骰子,每面向上的概率是多少,可能我们会不加思索会说是1/6,但是,如果说骰子的其中四点被做过特殊处理,四点向上的概率为1/3,那么其他点向上的概率则变为2/15。
首先,在骰子没做任何处理之前,我们认为骰子的各个面出现的概率是相同的,即符合均匀分布,此时熵最大。然后,当增加四点被做过特殊处理后,其他面的向上的概率变为2/15,在这里四点被做过特殊处理,即所谓的约束条件,满足约束条件之后,而对其它则不做任何假设其他面向上的概率是相同的,即为2/15,也是熵最大的。
在这个例子中,不作任何假设就是使用“等概率”,这个时候概率分布最均匀,从而使得概率分布的熵最大,即最大熵原理。
附录四:热力学第二定律的解释
有一种说法,宇宙诞生时是符合帕累托分布的,它的熵值很低,也具有很大的活力;宇宙热寂时,它的熵值很大,符合正态分布,也就是说事物的发展过程就是从幂律分布到正态分布。
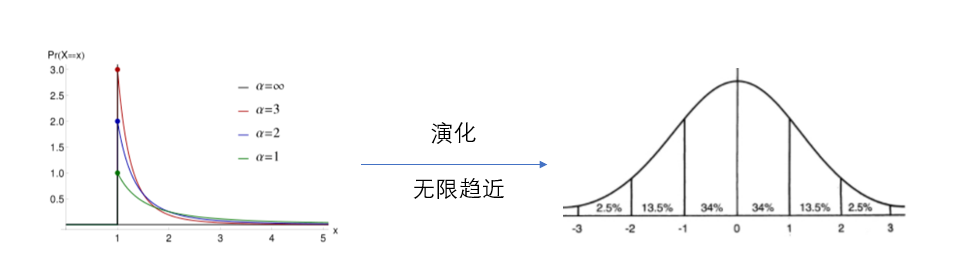
社会学还有一个叫做二八定律的东西,20% 的人掌握着社会 80% 的财富,把这种离散的模型迁移到连续的情况,这就是帕累托分布(这是一个厚尾模型,它的均值在采样无限时可以趋于无限大)。从其图像可以看到,采样时大部分样本都聚集在后面,但采样足够多时,总有几个非常大的样本来影响采样数据整体的分布,这个概率分布的熵值就很低。
马克思主义指出,资本主义必将演化到共产主义,也就是大部分财富在少部分人手中的幂等分布,最终必将演化到正态分布,即大部分财富掌握在大部分人手中!