大模型学习笔记之一:基本知识
一般认为,神经网络的三个核心要素是:
- 模型结构(Architecture):这是指神经网络的拓扑结构,包括层数、每层的神经元数量、神经元之间的连接方式等。例如,一个简单的多层感知机(MLP)包含输入层、一个或多个隐藏层以及输出层。
- 学习策略(Learning Strategy):涉及如何选择训练神经网络的方法,包括损失函数的选择、优化算法等。损失函数定义了模型预测与实际结果之间的差异如何计算,而优化算法则用于调整网络的权重以最小化损失函数。
- 激活函数(Activation Function):决定了神经网络如何处理和传递信息。它们通常用于在网络的每个神经元中引入非线性,使得网络能够学习和模拟复杂的函数映射。
一、张量(tensor)
张量(Tensor)是一个具有统一数据类型的多维数组,本质就是一组有序的数字。
张量的阶数(order)也称为维数(dimensions)、模态(modes)或方式(ways)。一个 N 阶张量是 N 个向量空间元素的张量积,每个向量空间都有自己的坐标系。实际上,引入 tensor 的目的就是把向量、矩阵推向更高的维度.
零阶张量是一个标量(scalar),一阶张量是一个矢量(vector,也称向量),二阶张量是一个矩阵(matrix),三阶或更高阶的张量叫做高阶张量(tensor)。
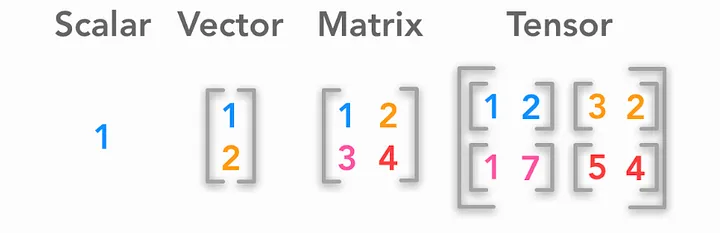
在 PyTorch 中,torch.Tensor是存储和变换数据的主要工具。如果你之前用过 NumPy,你会发现 Tensor 和 NumPy 的多维数组非常类似。然而,Tensor 提供 GPU 计算和自动求梯度等更多功能,这些使 Tensor 数据类型更加适合深度学习。
数学性质
张量的范数 - norm
张量的范数是其所有元素平方和的平方根,即:
这类似于矩阵 的 F范数(Frobenius norm).
张量的内积 - inner product
1 | import tensorflow as tf |
输出结果如下:
1 | tf.Tensor( |
数学运算
基本运算
- torch.add():加法
- torch.mul():乘法
- torch.div():除法
- torch.abs():tensor内每个元素取绝对值
- torch.round():tensor内每个元素取整数部分
- torch.frac():tensor内每个元素取小数部分
- torch.log():tensor内每个元素取对数
- torch.pow():tensor内每个元素取幂函数
- torch.exp():tensor内每个元素取指数
- torch.sigmoid():tensor内每个元素取sigmoid函数值
- torch.mean():tensor所有元素的均值
- torch.norm():tensor所有元素的范数值
- torch.prod():tensor所有元素积
- torch.sum():tensor所有元素和
- torch.max():tensor所有元素最大值
- torch.min():tensor所有元素最小值
注意:例如add()这类函数一般都是会返回一直tensor值的,但是add_()这类加了下划线的方法是在tensor的原空间处理的,会覆盖之前的值
同样也可以是用以下方式直接处理
加 tensor1 + tensor2;
减 tensor1 - tensor2;
乘 tensor1 * tensor2;
除 tensor1 / tensor2;
内积 tensor1 @ tensor2;
幂运算 tensor1 ** n
线性代数运算
- torch.dot():向量内积运算
- torch.mv():矩阵与向量的乘法
- torch.mm():矩阵乘法,仅适用二维矩阵;高维的矩阵乘法,使用 torch.matnul()
- torch.eig():方阵的特征值和特征向量
- torch.inverse():方阵的逆
- torch.ger():两个向量的张量积
连接、分片、变形
- torch.cat():多个tensor的拼接
- torch.reshape()\torch.view():返回一个张量,其数据和元素数量与输入相同,但具有指定的形状
- torch.transpose()\torch.t():指定tensor的两个维度进行转置,torch.t()方法只适用与二维tensor
- torch.squeeze()/unsqueeze():tensor对于张量中大小为1的维度的压缩与扩张
- torch.permute():返回维度排列后的原始张量输入的视图。
二、内积和外积(inner product & external product)
由于历史原因,数学学科和物理学科关于 inner product 和 outer product 两个词汇有着五花八门的翻译。
在数学学科,通常翻译成内积和外积,是两个名词的直译。点乘和叉乘是根据运算符号得来的俗称。
在物理学科,一般翻译成标积和矢积,表示运算的结果为标量和矢量,高中数学则称之为数量积和向量积。
内积(inner product)
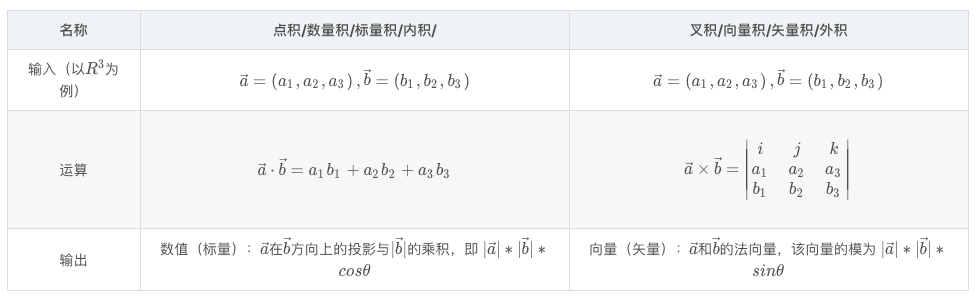
也称为点积(dot product)或数量积(scalar product),运算结果是一个标量。
数学定义为:已知两个向量 $a$, $b$,它们的夹角为 $\theta$,那么:
$$ a \cdot b = |a||b|\cos \theta$$
内积的代数定义,对于任意维数的向量都适用:
$$\vec{a} \cdot \vec{b} = \sum_{i=1}^{n}a_ib_i=a_1b_1+a_2b_2+…+a_nb_n$$
内积的几何意义:内积 $a \cdot b$ 等于 $a$ 的模与 $b$ 在 $a$ 方向上的投影的乘积。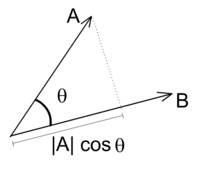
在欧几里得几何中,两个向量的笛卡尔坐标的点积被广泛使用。它通常被称为欧几里得空间的内积(或很少称为投影积),是内积的一种特殊情况,尽管它不是可以在欧几里得空间上定义的唯一内积。
内积满足以下性质:
- 满足交换律:$a \cdot b = b \cdot a$
- 满足加法的分配律:$a \cdot (b+c) = a \cdot b + a \cdot c$
- 不满足结合律:$(a \cdot b) \cdot c$ 和 $a \cdot (b \cdot c)$ 均无意义,因为无法定义一个标量和一个向量的运算
- 两个非零向量 $a$ 和 $b$是正交的,当且仅当 $a \cdot b = 0$
外积(external product)
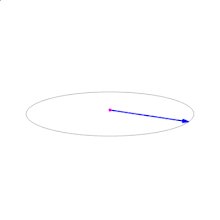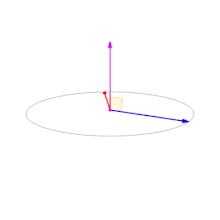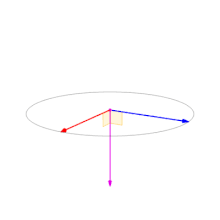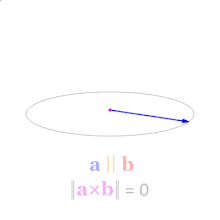
是三维向量特有的运算,也称为叉积(cross product)或向量积(vector product),运算结果是一个向量。
数学定义为:已知两个向量 $a$, $b$,它们的夹角为 $ \theta $,那么:
$$
a \times b := |a||b| \sin \theta,此时 a \times b 与 a,b 都垂直,且 a,b,a \times b 符合右手法则
$$
内积的代数定义,使用拉普拉斯展开:
$$
\begin{align*}
\textbf{u} \times \textbf{v} &=
\begin{vmatrix}
\textbf{i} & \textbf{j} & \textbf{k} \\
u_1 & u_2 & u_3 \\
v_1 & v_2 & v_3 \\
\end{vmatrix}
= \begin{vmatrix} u_2 & u_3 \\ v_2 & v_3 \end{vmatrix} \textbf{i} - \begin{vmatrix} u_1 & u_3 \\ v_1 & v_3 \end{vmatrix} \textbf{j} + \begin{vmatrix} u_1 & u_2 \\ v_1 & v_2 \end{vmatrix} \textbf{k} \\
&= (u_2v_3-u_3v_2) \textbf{i} - (u_1v_3-u_3v_1)\textbf{j} + (u_1v_2 - u_2v_1)\textbf{k}
\end{align*}
$$
外积的几何意义是:$a \times b$ 的长度是以 $a,b$ 为邻边的平行四边形的面积,$a \times b$ 的方向是垂直于$a$,$b$ 的法向量。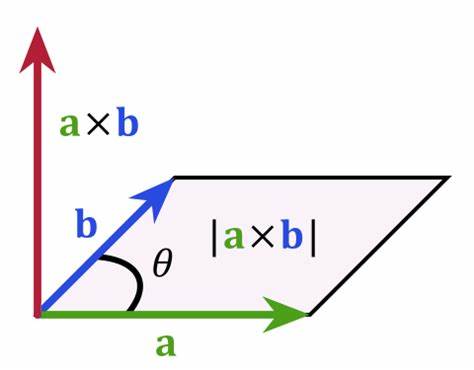
外积满足以下性质:
- $ \textbf{a} \times \textbf{a} = \textbf{0} $
- $ \textbf{a} \times \textbf{0} = \textbf{0} $
- 对于两个非零向量 $ \textbf{a} \times \textbf{b} = \textbf{0} $,当且仅当 $ \textbf{a} $ 平行于 $ \textbf{b} $
- 满足反交换律:$ ( \textbf{a} + \textbf{b}) \times \textbf{c} = \textbf{a} \times \textbf{c} + \textbf{a} \times \textbf{c} $,$ \textbf{a} \times (\textbf{b} + \textbf{c}) = \textbf{a} \times \textbf{c} + \textbf{b} \times \textbf{c} $
应用示例
向量内积在机器学习和深度学习领域具有广泛的应用,例如自然语言处理中判断两个单词的相似度,计算机图形学中判断两个矢量的方向性等:
- 如果点积 > 0,则它们的方向基本一致(同义词),数值越大表明相关性越强
- 如果点积 = 0,则他们的方向正交,即在空间上互相垂直,也即是不相关
- 如果点积 < 0,则它们的方向基本相反(反义词),数值越大表明负相关性越强
向量外积在计算机图形学中有广泛的应用,包括计算两个向量之间的夹角、计算两个平面的正交关系、计算三角形和多边形的面积、计算几何形状的表面积和体积、计算光线与物体表面的交叉关系,以及计算物体的旋转和转动等。
三、卷积(convolution)
在泛函分析中,卷积(convolution),也称叠积、褶积或旋积,是透过两个函数 $f$ 和 $g$ 生成第三个函数的一种数学算子,表征函数 $f$ 与经过翻转和平移的 $g$ 的乘积函数所围成的曲边梯形的面积。
卷积其实就是为冲击函数诞生的。“冲击函数”是狄拉克为了解决一些瞬间作用的物理现象而提出的符号,例如在 t 时间内对一物体作用 F 的力,对它进行积分(求面积)就代表了力 F 在时间 t 上的累积效果,也就是冲量。
换句话说,如果将参加卷积的一个函数看作区间的指示函数,卷积也可以被看作是“移动平均”的推广,在“信号与系统”中得到广泛应用。
数学定义
设:$ f(t) $ 和 $ g(t) $ 是在实数 $ R $ 上的两个可积函数,则定义:
$$
f(t) * g(t) := \int_{-\infty}^{\infty} f(\tau)g(t-\tau)d(\tau)
$$
若为离散情况,就是级数形式了:
$$
f(n) * g(n) := \sum_{-\infty}^{\infty} f[k]g[n-k]
$$
满足如下性质:
- 交换律:$ f * g = g * f $
- 结合律:$ f * ( g * h) = (f * g) * h $
- 分配律:$ f * (g + h) = f * g + f * h $
- 微分有关:$ (f*g)’ = f’ *g = f *g’ $
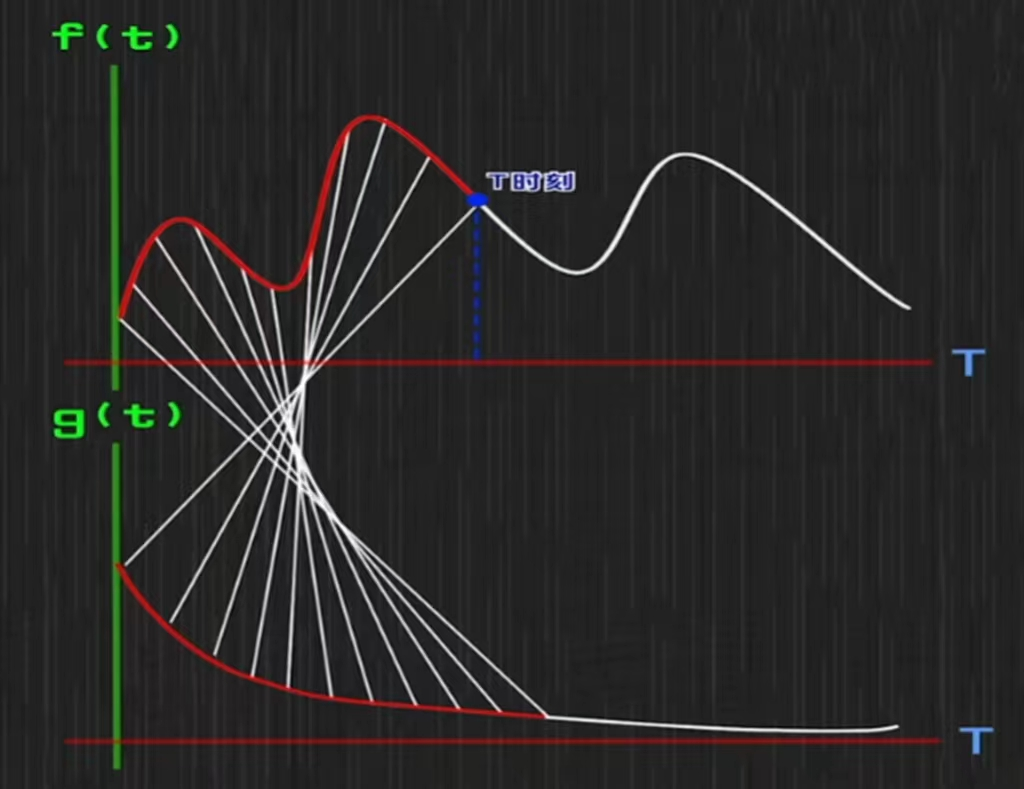
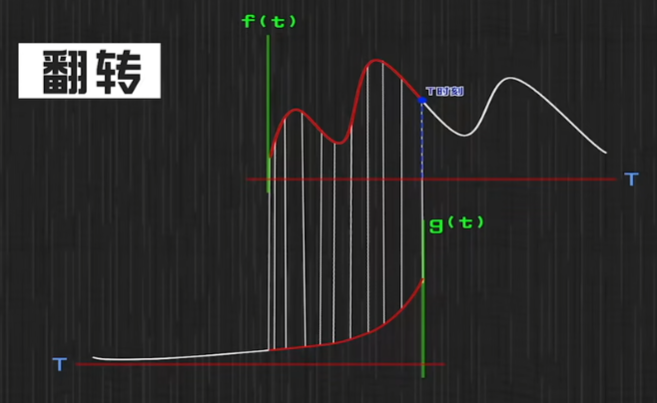
应用实例
- 代数中,整数乘法和多项式乘法都是卷积。
- 统计学中,加权的滑动平均是一种卷积。
- 概率论中,两个统计独立变量X与Y的和的概率密度函数是X与Y的概率密度函数的卷积。
- 声学中,回声可以用源声与一个反映各种反射效应的函数的卷积表示。
- 物理学中,任何一个线性系统(符合叠加原理)都存在卷积。
在工程技术中的应用更加重要:
- 卷积神经网络,应用了多重级联的卷积核心,它被用于机器视觉和人工智能,尽管在多数情况下实际上用的是互相关而非卷积
- 传统计算机图像处理中,用作图像模糊、锐化、边缘检测
- 信号处理中,任一个线性系统的输出都可以通过将输入信号与系统函数(系统的冲激响应)做卷积获得
附录:名词解释
MOE(Mixture of Experts,专家混合)模型
MOE 是一种深度学习架构,它将多个专家(experts)网络组合在一起,并通过一个门控(gating)网络来决定每个输入样本应该由哪个专家网络来处理。每个专家网络通常是一个小型的神经网络,它们专注于学习数据的不同部分或特征。
过拟合 & 泛化
梯度消失、梯度爆炸
dropout、masked
超参数
学习率(learning rate,例如 10%)也是超参数,可以动态吗?
SVM(Support Vector Machine,支持向量机)
SVM 是一种监督学习算法,主要用于分类和回归分析。它在解决小样本、非线性、高维数据的问题上表现出色,因此在机器学习领域得到了广泛的应用。
Perceptron(感知机)
Perceptron 是最早的人工神经网络模型之一,由 Frank Rosenblatt 在 1957 年提出。它是一种简单的线性二分类模型,用于处理和分类数据。
感知机由输入层、权重、偏置项和激活函数组成。输入层接收多个输入特征,每个特征都有一个对应的权重。输入特征和权重的点积加上偏置项构成了感知机的净输入。
感知机可以看作是现代神经网络的一个特例,其中每个神经元只进行线性计算。现代神经网络通过堆叠多个感知机层(隐藏层)和引入非线性激活函数,能够解决更复杂的问题。
Kernel Function(核函数)
核函数(Kernel Function)是机器学习中的一种数学工具,主要目的是将数据映射到一个更高维的空间,以便在这个新空间中应用线性模型来解决原始空间中的非线性问题。
常见的核函数有:线性核、多项式核、径向基函数核(Radial Basis Function Kernel,RBF,就是高斯核),Sigmod 核等。
核函数是 SVM 处理非线性问题的关键技术,它允许 SVM 在高维特征空间中进行有效的线性分割,同时避免了直接在高维空间中进行计算的高成本。通过精心选择核函数和调整其参数,SVM 能够应用于各种复杂的数据集和问题。