大模型学习笔记之二:激活函数
一、概述
神经网络中的每个神经元节点接受上一层神经元的输出值作为本神经元的输入值,并将输入值传递给下一层,输入层神经元节点会将输入属性直接传递到下一层(隐层或输出层)。在多层神经网络中,上层节点的输出和下层节点的输入之间具有一个函数关系,这个函数称为激活函数(activation function)。
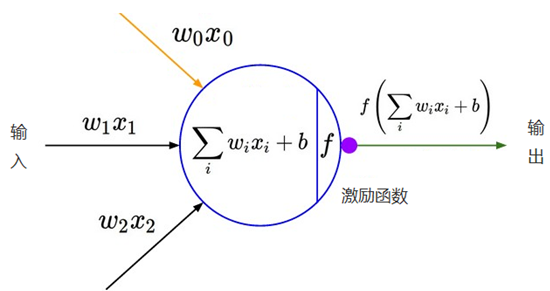
$\sum\limits_{i}{w_{i}x_{i}+b}$ 是线形组合部分,$f()$ 部分就是激活函数,核心用途是为神经元加入非线性因素!
从哲学的角度看,线性组合解决的是描述问题,激励函数解决的是判断问题,就是价值观!
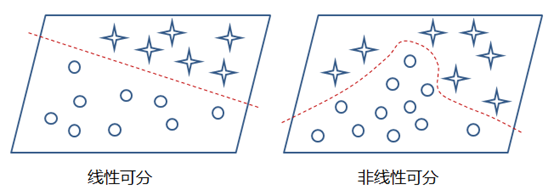
在神经网络中,如果不对上一层结点的输出做非线性转换的话(即:激活函数为$f(x)=x$),再深的网络也是线性模型,只能把输入线性组合再输出,不能学习到复杂的映射关系,就是最原始的感知机(perceptron),那么网络的逼近能力就相当有限,因此需要使用激活函数提供非线性转换,这样深层神经网络表达能力就更加强大了,几乎可以逼近任意函数。
设计一个合格的激活函数,必须满足以下性质:
- 非线性:这是激活函数的基本要求,目的就是提供超越线形组合的表达能力
- 可微性:当优化方法是基于梯度的时候,这个性质是必须的。
连续性是指函数在某一点的极限值等于该点的函数值;
可微性是指函数在某一点附近的变化率可以表示为该点的一个线性变换;
可导性是指函数在某一点存在切线,且切线的斜率是确定的。
注意!可微一定可导,可微一定连续,但反之并不一定! - 单调性:当激活函数是单调的时候,单层网络能够保证是凸函数
- $f(x) \approx x$:当激活函数满足这个性质的时候,如果参数的初始化是 random 的很小的值,那么神经网络的训练将会很高效;如果不满足这个性质,那么就需要很用心的去设置初始值
- 有限输出:当激活函数的输出值是有限的时候,基于梯度的优化方法会更加稳定,因为特征的表示受有限权值的影响更显著;当激活函数的输出是无限的时候,模型的训练会更加高效,不过在这种情况下,一般需要更小的 learning rate。
根据输入变量的数量,激活函数分为单变量输入$f(x)$ 和 多变量输入$f(x_1,..x_n)$。
二、单变量输入的激活函数
1. Sigmoid(S型函数)
Sigmoid 函数把一个实数(输入的连续实值)压缩到 0 到 1 之间,当输入的数字非常大的时候,结果会接近 1(完全被激活),当输入非常大的负数时,则会得到接近 0 (几乎死掉了),很好地解释了神经元受到刺激后是否被激活,并向后传递的场景,因此在早期的神经网络中使用非常普遍!
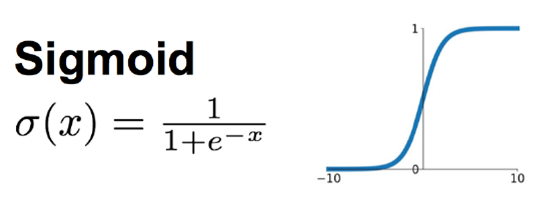
不过,其在近期深度学习的应用中已经很少使用,主要存在以下缺点:
- 当神经网络的层数很多时,如果每一层的激活函数都采用 Sigmoid 函数的话,就会产生梯度弥散和梯度爆炸的问题,其中梯度爆炸发生的概率非常小,而梯度消失的发生概率比较大。
- 计算量大,因为解析式中含有幂函数,对于规模比较大的深度网络,这会较大的增加训练时间
- Sigmoid 函数的输出均值不是 0 ,这是不可取的
zero-centered 问题:如果当前参数($w_0$, $w_1$)的最佳优化方向是 ($+d_0$, $-d_1$),则根据反向传播计算公式,我们希望 $x_0$ 和 $x_1$ 符号相反,但是如果上一级神经元采用 Sigmoid 函数作为激活函数,其输出值恒为正,那么我们无法进行更快的参数更新,只能走 Z 字形逼近最优解。
2. Tanh(Hyperbolic tangent,双曲正切函数)
在数学中,双曲正切 tanh 是由双曲正弦和双曲余弦这两个基本双曲函数推导而来。
$$
tanh(x)=\dfrac{(e^x-e^{-x})}{(e^x+e^{-x})}
$$
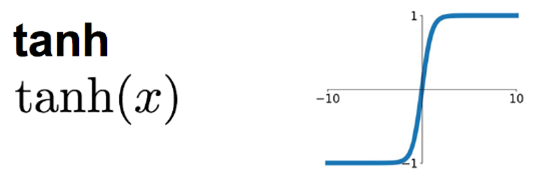
与 Sigmoid 相比,tanh 函数有了明显改进,但有些问题依然存在:
- tanh 函数输出位于[-1,1],解决了 Sigmoid 函数输出的 zero-centered 问题
- 收敛速度比 Sigmoid 更快,减少迭代次数,梯度消失问题有所缓解,但仍然存在!
- 计算量仍然加大,因为解析式中仍然包含幂函数!
3. ReLU(Rectified Linear Unit, 线形整流函数)
针对 Sigmoid 函数和 tanh 的缺点,提出了一种斜坡函数,就是 ReLU函数。
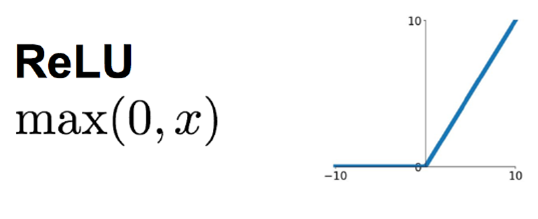
ReLU 是目前最受欢迎的激活函数!突出优点是:
- 解决了梯度消失(gradient vanishing)问题,仅在正区间部分
- 计算速度快,求导方便,只需要判断输入是否大于0
- 收敛速度远远大于 Sigmoid函数和 tanh 函数,可以加速网络训练
也有一些缺点:
- 由于负数部分恒为零,有些场景下比较脆弱。即如果变量的更新太快,还没有找到最佳值就进入小于零的分段,就会使得梯度变为零,神经元就直接死掉了(无法更新)
- 输出不是 zero-centered
解决方法是可以采用 Xavier 初始化方法,以及避免将 learning rate 设置太大或使用 adagrad 等自动调节 learning rate 的算法。
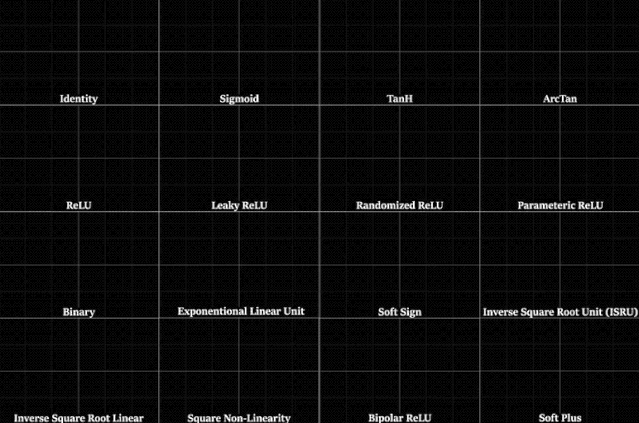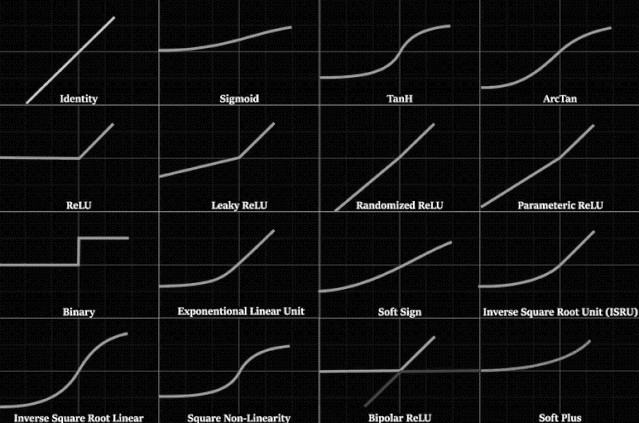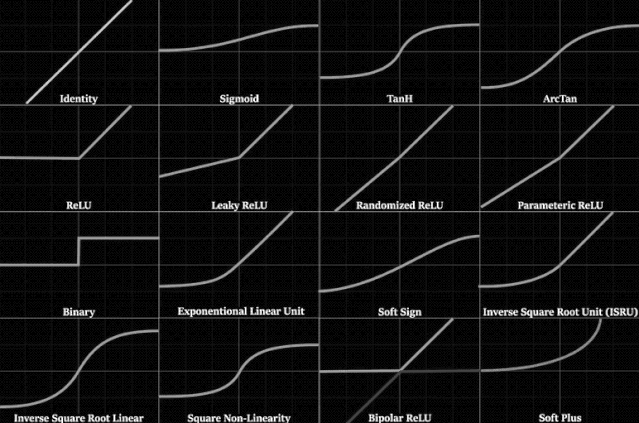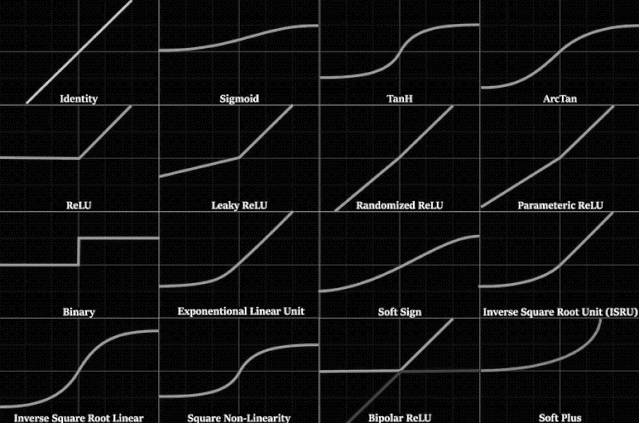
为了改进 ReLU 的缺点,陆续出现了许多的变种,如下图: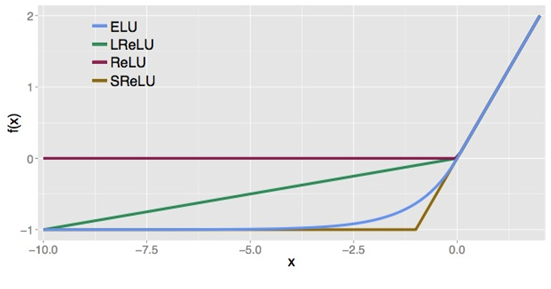
Leak-ReLU(Leakly Rectified Linear Unit,带泄露线性整流函数)
为了避免 ReLU 存在的梯度消失问题,提出了将 ReLU 的前半段设为 $ax$ 而非 0,即当神经元处于非激活状态时,允许一个非0的梯度存在,a 可由方向传播算法学出来,通常设置为 0.01。也称为 LReLU 。
$$f(x)=max(ax, x)$$
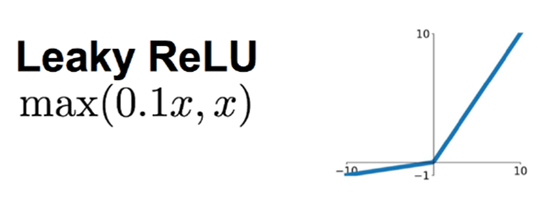
理论上来说,Leaky ReLU 具备 ReLU的所有优点,外加不会有 Dead ReLU 问题,但是在实际操作当中,并没有完全证明 Leaky ReLU 总是好于 ReLU。
RReLU(Random Rectified Linear Unit,随机线性整流单元)
Leaky ReLU的一个变体。在 PReLU中,负值的斜率在训练中是随机的,在之后的测试中就变成了固定的了。
4. ELU(Exponential Linear Unit,指数线性函数)
一个 ReLU 的进化版,正数部分是和 ReLU 完全相同的 $x$ ,但负数部分是 $\alpha(e^x-1)$ 。
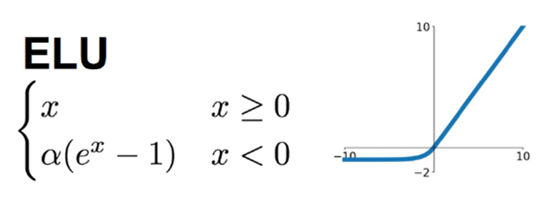
ELU 试图将激活函数的平均值接近零,从而加速学习的速率。同时它融合了 Sigmoid 和 ReLU,左侧具有软饱和性,右侧无饱和性,则可以通过正值的标识来避免梯度消失的问题。根据一些研究,ELU 分类精确度是高于 ReLUs的。
SELU(Scaled Exponential Linear Unit,扩展指数线形函数)
一个 ELU 的变种,把每一个值的前面都乘上一个系数,即:正数部分为 $\lambda x$ ,负数部分为 $\lambda\alpha(e^x-1)$ 。
有关数学推导表明,最佳参数为:$\alpha$=1.67326324,$\lambda$=1.050700987。
5. 其他
除了上述流行的激活函数,还有一些可选项:
- ReLU6:就是普通的 ReLU,但是限制最大输出值为 6,适配移动端设备 float16 的低精度。
- SReLU(Sigmoid Rectified Linear Unit,S型线形整流函数):有多个复杂变种,此处略。
- 正弦函数:$f(x)=sin(x)$
- 高斯函数:$f(x)=e^{-x^2}$
三、多变量输入的激活函数
1. Softmax 函数
Softmax 是一种激活函数,将一个数值向量归一化为一个概率分布向量,且各个概率之和为 1。
$$ Softmax(z_i)=\frac {e^{z_i}} {\sum\limits_{j=1}^{n} e^{z_j}} $$
正常的 max 函数仅输出最大值,但 Softmax 函数确保较小的值具有较小的概率,并且不会直接丢弃。可以认为它是 argmax 函数的概率版本或“soft”版本。
Softmax 函数的分母结合了原始输出值的所有因子,这意味着 Softmax 函数获得的各种概率彼此相关。
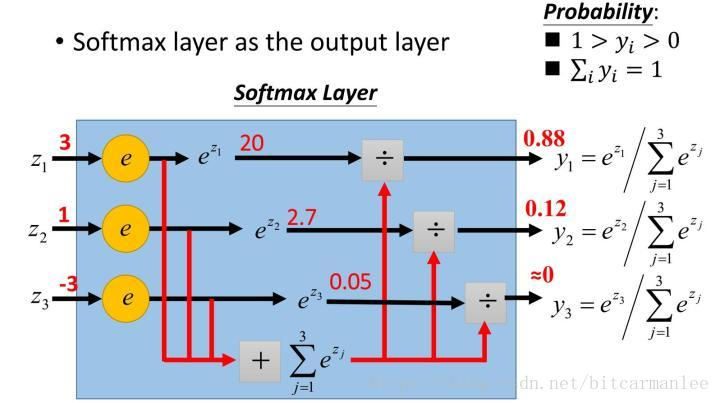
Softmax 通常作为神经网络的最后一层,用于多分类问题的输出,它将多个神经元的输出,映射到(0,1)区间内,可以看成概率来理解,从而来进行多分类,常常和交叉熵损失函数一起结合使用。
下面是使用Python进行函数计算的示例代码:
1 | import math |
2. Maxout 函数
Maxout 是 Goodfellow 在 2013 年提出的一个新的激活函数,相比于其它的激活函数,Maxout 本身是需要参数的,参数可以通过网络的反向传播得到学习。
$$f(x)=\max(w_1x^T + b_1, w_2x^T + b_2, …, w_nx^T + b_n)$$
Maxout 的本质是分段线性拟合,理论上可以拟合任意的凸函数;同时,由于其应用了 max 函数,又具备非线形的特征,因此比其它激活函数有着更好的性能的应用,换个角度看,如果 w 和 b 都设置为 0 ,就转换为 ReLU 函数。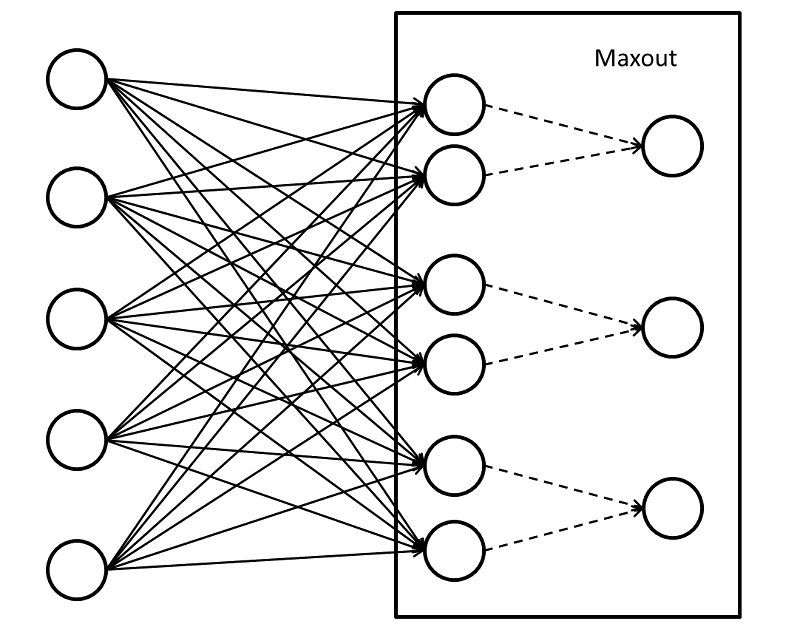
Maxout 连接与普通的全连接并无区别,之后每两个单元连接到一个单元上,当然,这里不是真的连接,因为该条线上并不涉及参数,那么如何从两个单元得到一个单元的值呢?其实只需要比较两个单元的值即可,大的值就是 MaxOut。
Maxout 继承了 RELU 的优点而且没有死区,但是需要 2 次线性映射运算,因此计算量也会翻倍。
四、简要分析
1. Sigmoid 和 Softmax
- Sigmoid 函数将模型的输出转化为概率形式,即将任意实数映射到(0,1)区间,从而解决了归一化问题
- Softmax 是 Sigmoid 的扩展形式,即 Sigmoid 是 Softmax 在二分类情况下的特例。即:
$$Softmax([z,0]) = [\frac {e^z}{e^z+1}, \frac {1}{e^z+1}]$$ - 使用 Sigmoid & Softmax = 选择了最大熵原理,因此模型的中间层可能使用其他激活函数(为了解决梯度消失问题),但最终输出必然使用 Softmax
2. 模型的温度
对于 Softmax 函数,我们可以使用不同的基底参数,其结果仍然服从归一化概率分布,但数值分布发生了变化。
$$ Softmax(z_i)=\frac {e^{z_i/T}} {\sum\limits_{j=1}^{n} e^{z_j/T}} $$
其中,$z_i$ 是模型输出的第 $i$ 个元素,$T$ 称为温度调整(Temperature Scaling)参数,默认值为 1。
- 温度 $T$ 较低时,Softmax 输出的概率分布更加尖锐,即一个值占主导地位(结果的确定性更高);
- 温度 $T$ 较高时,分布更加平坦,即类别之间的概率差异减小(系统熵增加,随机性更高)。
- 在实际应用和计算中,$T$ 不能设置为 0(分母为零没有意义),但可以是一个非常小的数字( Pytorch 通常设置 $eps=1e^{-6}$),此时函数表现行为就是最大值的概率为100%
3. 函数选择的基本策略
- 首先尝试 ReLU,速度快,但是要注意训练的状态
- 如果 ReLU 效果欠佳,尝试 Leaky ReLU 或者 Maxout 等变种
- 最好不用 Sigmoid 函数,可以尝试 tanh 函数,但通常其效果比不上 ReLU 和 maxout
- Sigmoid tanh 在 RMM(LSTM 注意力机制等)结构中有所应用,作为门控或者概率值
- 在浅层神经网络中,如不超过四层,可选择使用多种激励函数,没有太大的影响
- 如果是使用 ReLU,那么一定要小心设置 learning rate,而且要注意,不要让网络出现很多“dead”神经元,如果这个问题不好解决,那么可以试试 Leaky ReLU ,PReLU , 或者 Maxout。