大模型学习笔记之三:损失函数
在机器学习中,损失函数是代价函数的一部分,而代价函数则是目标函数的一种类型。
- 损失函数(Loss function):用于定义单个训练样本与真实值之间的误差;
- 代价函数(Cost function):用于定义单个批次,或整个训练集样本与真实值之间的误差;
- 目标函数(Objective function):泛指任意可以被优化的函数。
损失函数是用于衡量模型所作出的预测离真实值(Ground Truth)之间的偏离程度。
一、概述
在深度学习广为使用的今天,我们可以在脑海里清晰的知道,一个模型想要达到很好的效果需要学习(=训练)。一个好的训练离不开优质的负反馈,损失函数(Loss Functions)就是模型的负反馈。简化地说,损失函数可以定义为具有两个参数的函数:一是预测输出(Predicted Output),二是实际输出(True Output)。
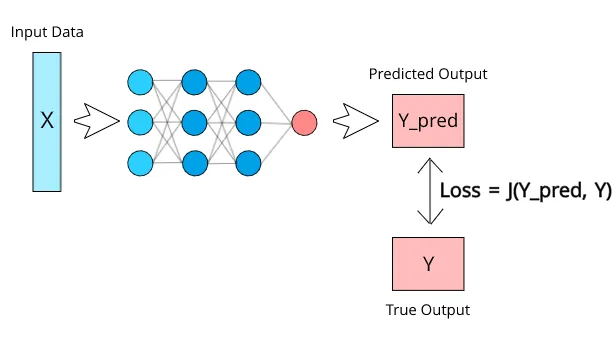
对于样本空间 $X$ 的某个训练样本 $x$,人脑中有一个真实的概率分布模型,其输出就是正确答案 $y$,而神经网络就是基于内置参数 $(w,b)$ 计算预测的另一个概率分布模型,其输出 Y_pred 就是$f(x)$,所谓损失函数就是比较真实分布和预测分布之间的差距。若损失函数很小,表明机器学习模型与数据真实分布很接近,则模型性能良好;若损失函数很大,表明机器学习模型与数据真实分布差别较大,则模型性能不佳。
损失函数大致可分为两种,一是分类问题,其目标是预测一个离散的标签(判断题),例如垃圾邮件检测、疾病诊断等;二是回归问题,其目标是预测一个连续的数值(填空题),例如房价预测、气温预测等。主要区别是:
- 问题类型:回归问题面向连续性变量,分类问题面向离散型变量
- 误差度量:回归问题关注预测值与实际值之间的差异,表示为 $y-f(x)$,也称为“残差(Residual)”;而分类问题关注的是预测类别是否正确,表示为 $yf(x)$,也称为“边界(Margin)”
- 优化目标:回归模型优化的是预测值与实际值之间的连续误差,分类模型优化的是预测类别的准确性
俗话说,任何事情必然有它的两面性,因此,并没有一种万能的损失函数能够适用于所有的机器学习任务,所以在这里我们需要知道每一种损失函数的优点和局限性,才能更好的利用它们去解决实际的问题。
二、面向分类的损失函数
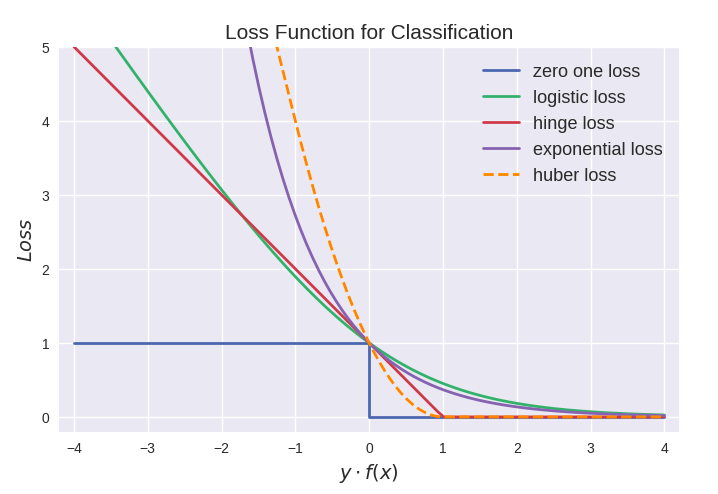
对于二分类问题,定义 $y \in \{ −1,+1 \} $,损失函数最直观的思路就是0-1损失(zero-one loss),数学表达为:
$$ L(y,f(x)) = \begin {cases}
0,& yf(x) \geq 0 \\
1,& yf(x) < 0
\end{cases}
$$
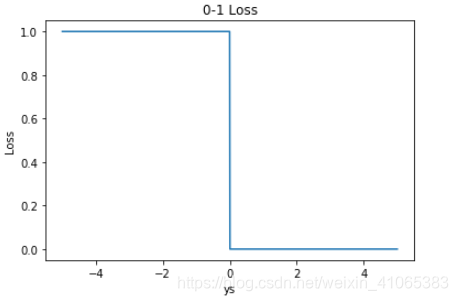
0-1损失函数存在两个明显的问题,一是对每个错误的分类点都施以相同的惩罚(取值1),这样那些“错的离谱“ (即 $yf(x) 是一个很大的负数)的样本并没有接受较大的惩罚,这在直觉上不是很合适;二是函数不连续、非凸的特点导致计算不方便,因而我们通常使用其他的代理损失函数进行优化。
1. Cross Entropy Loss(交叉熵损失函数)= Logistic Loss(对数损失函数)
物理学上的熵表示一个热力学系统的无序程度。为了解决对信息的量化度量问题,香农在 1948年 提出了“信息熵”的概念,使用对数函数表示对不确定性的测量。熵越高,表示能传输的信息越多,熵越少,表示传输的信息越少,可以直接将熵理解为信息量。交叉熵(cross-entropy,CE)刻画了两个概率分布之间的距离,更适合用在分类问题上,因为交叉熵表达预测输入样本属于某一类的概率。
可以证明,交叉熵,KL散度,极大似然估计这几种求解模型参数的方法,最终的结果都是等价的,由于交叉熵形式比较接近最终损失函数形式,人们默认交叉熵就是 softmax 分类器的损失函数。
但是要注意,这三者等价的前提是:标签只有一类是正确分类(即 one-hot),这符合分类问题的定义。但如果你考虑的问题不是分类问题,或者标签是非平凡的(并不只有一类为1,其它全为0),再使用交叉熵就不合理了。
二分类
对于给定输入的样本 $x_i$,人脑的真实分布输出(即标签)为 $y_i$,取值为 $y_i \in \{0,1\}$(集合,非0即1),而预测模型的输出 $f(x_i)$ 记为 $\hat{y_i}$,通常使用 Sigmoid 函数压缩为 $\hat{y_i} \in [ 0,1 ]$ (闭区间,从0到1的所有实数)。
假设单个观测的数据遵循伯努利分布(扩展到固定数量的独立观测,就是二项分布)。根据伯努利分布(Bernoulli distribution,也称两点分布或者0-1分布),记其成功概率为 $p(0 \leqslant p \leqslant 1)$,失败概率为 $q=1-p$,其概率密度函数为:
$$ f(x)=p^x(1-p)^{(1-x)} =
\begin{cases}
p, & x = 1 \\
1-p, & x =0
\end{cases}
$$
则有:
$$p(y_i|x_i) = (\hat{y_i}^{y_i})(1-\hat{y_i})^{1-y_i}$$
假设数据点之间独立同分布,则似然值可以表示为
$$L(x,y) = \prod_{i=1}^{n} (\hat{y_i}^{y_i})(1-\hat{y_i})^{1-y_i} $$
对似然值取对数,然后加负号变成最小化负对数似然值,即为交叉熵损失函数的形式:
$$Loss(y_i,\hat{y_i}) = - \sum_{i=1}^{n} (({y_i} \log \hat{y_i}) + (1-y_i) \log (1-\hat{y_i})) $$
对公式的解释如下:
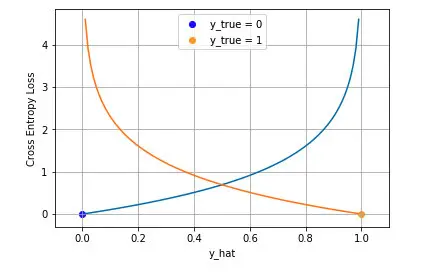
- 当 $y_i=1$(样本标签为正类)时,损失函数为 $- \log \hat{y_i}$,损失与模型预测为正类的概率的对数成正比
- 当 $y_i=0$(样本标签为负类)时,损失函数为 $- \log (1-\hat{y_i})$,损失与模型预测为负类的概率的对数成正比
多分类
以二分类问题为基础,扩展到多分类问题,则有:
假设有 $C$ 个类别,每个样本 $x_i$ 的实际标签为 $y_i$ ,其中 $y_i$ 是一个独热编码的向量,表示类别的索引。模型预测每个类别的概率分布为 $\hat{y_i}$,其中 表示 $\hat{y_{i,c}}$ 样本属于类别 $c$ 的预测概率。
交叉熵损失函数的数学定义为:
$$Loss(y_i,\hat{y_i}) = - \sum_{i=1}^{n} \sum_{c=1}^{C} y_{i,c} \log{\hat{y_{i,c}}}$$
其中:
- $y$ 是实际标签的集合
- $\hat y$ 是模型预测的概率分布
- $n$ 是样本数量
- $C$ 是类别数量
- $y_{i,c}$ 是独热编码的实际标签,如果样本 $x_i$ 属于类别 $c$ 则 $y_{i,c}$=1,否则 $y_{i,c}$=0
- $\hat{y_{i,c}}$ 是模型预测样本 $x_i$ 属于类别 $c$ 的概率。
总结一下,交叉熵 Loss 的优点是在整个实数域内,Loss 近似线性变化。尤其是当 margin << 0 的时候,Loss 更近似线性。这样,模型受异常点的干扰就较小。 而且,交叉熵 Loss 连续可导,便于求导计算,是使用最广泛的损失函数之一。
2. Focal Loss(焦点损失函数)
Focal loss 损失函数是为了解决 one-stage 目标检测中正负样本极度不平衡的问题,是一个密集目标检测的损失函数。在训练深层神经网络解决目标检测和分类问题时,这是最常见的选择之一。
焦点损失,出自何凯明的Focal Loss for Dense Object Detection,出发点是解决目标检测领域中 one-stage 算法(如 YOLO 系列算法)准确率不高的问题。作者认为样本的类别不均衡(比如前景和背景)是导致这个问题的主要原因。比如在很多输入图片中,我们利用网格去划分小窗口,大多数的窗口是不包含目标的。如此一来,如果我们直接运用原始的交叉熵损失,那么负样本所占比例会非常大,主导梯度的优化方向,即网络会偏向于将前景预测为背景。即使我们可以使用 OHEM(在线困难样本挖掘)算法来处理不均衡的问题,虽然其增加了误分类样本的权重,但也容易忽略掉易分类样本。而 Focal loss 则是聚焦于训练一个困难样本的稀疏集,通过直接在标准的交叉熵损失基础上做改进,引进了两个惩罚因子,来减少易分类样本的权重,使得模型在训练过程中更专注于困难样本。
Focal Loss 的数学公式为:
$$ FL = -\alpha_t(1-\hat{p_t})^\gamma \log(\hat{p_t})$$
其基本定义如下:
- $\hat{p_t}$ 是模型对于每个类别 $t$ 的预测概率
- $y_t$ 是实际的标签,如果样本属于类别 $t$,则 $y_t=1$,否则 $y_t=0$
- $\alpha_t$ 是一个平衡正负样本的权重因子,通常对于正样本设置为 1,对于负样本可以设置为一个较小的值。
- $\gamma$ 是一个调节因子(focal系数),用于减少对易分类样本的关注,通常设置为 2 或 5
- 当 $\hat{p_t}$ 接近 1(对于正样本)或 0(对于负样本)时,$(1-\hat{p_t})^\gamma$ 项会接近 0,以减少这些样本的损失贡献
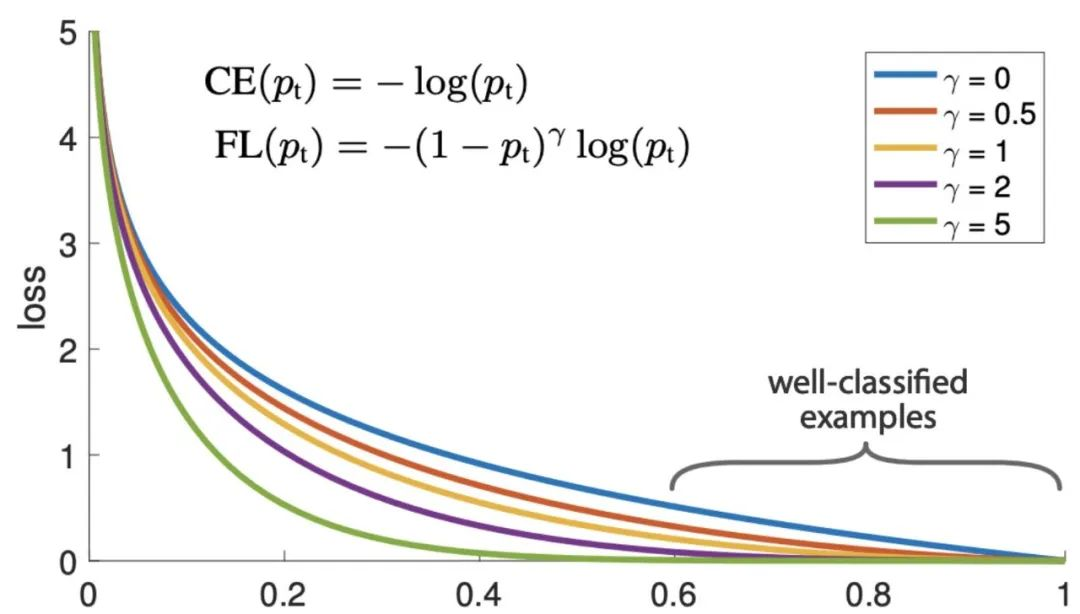
实验中,作者取($\alpha_t$=0.25,$\gamma$=0.2)的效果最好,具体还需要根据任务的情况调整。由此可见,应用 Focal-loss 也会额外引入两个超参数,需要丰富的经验才能调好。
3. Exponential Loss(指数损失函数)
Exponential Loss,又称指数损失,其表达式如下:
$$Loss(y,f(x)) = e^{-yf(x)}$$
Exponential Loss 与交叉熵损失函数类似,但它是指数下降的,因此梯度较其它损失函数更大一些。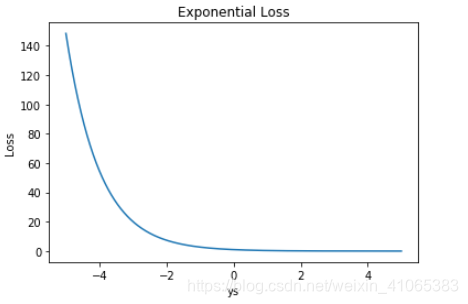
Exponential Loss 是 AdaBoost 中使用的损失函数,可以比较方便地利用加法模型推导出 AdaBoost 算法。然而其和Squared Loss 一样,对异常点较为敏感,鲁棒性不够。
4. Hinge Loss(合页损失函数)
Hinge loss 损失函数通常适用于二分类的场景中,可以用来解决间隔最大化的问题。数学表达为:
$$ Loss(y,f(x)) = max(0, 1-yf(x))$$
Hinge 损失函数将与分类边界之间的差值或距离纳入成本计算。即使新的观察结果被正确分类,如果决策边界的差距不够大,它们也会受到惩罚,损失呈线性增加。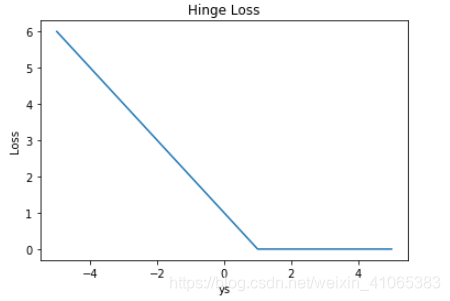
Hinge Loss 的形状就像一本要合上的书,故称为合页损失。显然,只有当 ys < 1 时,Loss 才大于零;对于 ys > 1 的情况,Loss 始终为零。Hinge Loss 一般多用于支持向量机(SVM)中,体现了 SVM 距离最大化的思想。而且,当 Loss 大于零时,是线性函数,便于梯度下降算法求导。
Hinge Loss 的另一个优点是使得 ys > 0 的样本损失皆为 0,由此带来了稀疏解,使得 SVM 仅通过少量的支持向量就能确定最终超平面。
5. Huber Loss(Huber损失函数)
Huber Loss 结合了均方损失(MSE)和绝对值损失(MAE)的优点,当 $|y-f(x)|$ 小于一个指定的 $\delta$(=-1) 时,变为平方损失,大于 $\delta$(=-1)时变为绝对值损失,因此比前两者更有鲁棒性。数学表达是:
$$Loss(y,f(x)) =
\begin{cases}
0, & yf(x) \geqslant 1 \\
(1-yf(x))^2, & 0 > yf(x) \geqslant -1 \\
-4yf(x), & yf(x) < -1
\end{cases}
$$
从表达式和 Loss 图形上看,Huber Loss 结合了 Hinge Loss 和 交叉熵 Loss 的优点。一方面能在 ys > 1 时产生稀疏解提高训练效率;另一方面对于 ys < −1 样本的惩罚以线性增加,这意味着受异常点的干扰较少。
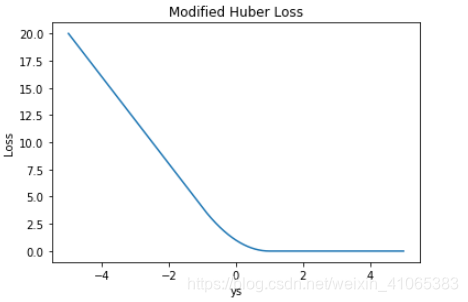
Huber Loss 既可以用于回归问题,也能应用于分类问题中.
三、面向回归的损失函数
回归问题中 y 和 f(x) 都是实数,因此直接使用残差( $y−f(x)$)来度量二者的不一致程度。残差 (的绝对值) 越大,则损失函数越大,学习出来的模型效果就越差(这里不考虑正则化问题)。
1. MAE(Mean Averange Error,平均绝对误差)
平均绝对误差(MAE)是另一种常用的回归损失函数,它是目标值与预测值之差绝对值和的均值,表示了预测值的平均误差幅度,而不需要考虑误差的方向,也称为 L1 Loss 损失函数(注:平均偏差误差 MBE 则是考虑的方向的误差,是残差的和),范围是 0 到 $\infty$,其公式如下所示:
$$ MAE = \frac{1}{N} \sum_{i=1}^{N} \vert y_i-f(x_i) \vert $$
2. MSE(Mean Square Error,均方误差)
均方误差(Mean Square Error,MSE)是回归损失函数中最常用的误差,它是预测值f(x)与目标值y之间差值平方和的均值,也称为 L2 Loss 损失函数,其公式如下所示:
$$ MSE = \frac{1}{N} \sum_{i=1}^{N} (y_i-f(x_i))^2 $$
3. Huber Loss
MSE 和 MAE 各有优点和缺点,Huber 提出了一个综合二者特点的改进方案,公式如下:
$$ Loss(y,f(x)) =
\begin{cases}
\frac {1}{2} (y-f(x))^2, & \vert y-f(x) \vert < \delta \\
\delta \vert y-f(x) \vert - \frac {1}{2} \delta ^2, & \vert y-f(x) \vert \geqslant \delta
\end{cases}
$$
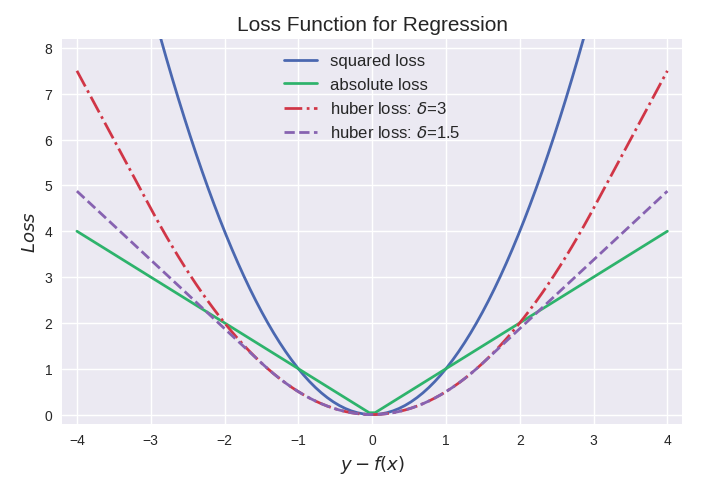
Huber Loss 包含了一个超参数$\delta$,$\delta$ 的大小决定了 Huber Loss 对 MSE 和 MAE 的侧重性,使其同时具备两者的优点,减小了对离群点的敏感度问题,还实现了处处可导的功能。
- 当$\vert y−f(x) \vert < \delta$ 时,变为 MSE,梯度逐渐减小,保证模型更精确地得到全局最优解
- 当$\vert y−f(x) \vert \geqslant \delta$时,则变成类似于 MAE,梯度一直近似为 $\delta$ ,保证了模型的快速收敛
通常来说,超参数 $\delta$ 可以通过交叉验证选取最佳值。下面分别取 $\delta$ = 3、$\delta$ = 1.5,绘制相应的 Huber Loss,如下图所示:
4. Smooth L1(平滑之后的L1)
根据 PyTorch SmoothL1Loss 函数的定义,其公式为:
$$ Loss(y,f(x)) =
\begin{cases}
\frac{1}{2\delta}(y-f(x))^2, & \vert y - f(x) \vert < \delta \\
\vert y-f(x) \vert - \frac {1}{2}\delta, & \vert y - f(x) \vert \geqslant \delta
\end{cases}
$$
Smooth L1 Loss 与 Huber Loss 的效果差不多,只是构造函数有所区别。
三、简要分析
1. 面向分类的损失函数通常使用交叉熵,为什么不使用均方差损失?
在统计学中,平均平方误差是对于无法观察的参数 $\theta$ 的一个估计函数,通常与高斯分布(正态分布)相关联。例如,线性回归模型通常假设数据的误差(预测值与实际值之间的差异)是随机的,并且遵循均值为零、恒定方差的正态分布。
面向分类问题的结果,通常是一个离散的标签值(二分类就是[0,1]),此时用正态分布来描述误差显然是不合适的,因此我们直接衡量预测概率与实际标签之间的差异,即关注于模型预测的概率分布是否接近实际的标签分布,也就是极大似然估计法,其等价于交叉熵法。
2. 面向分类的损失函数
3. 面向回归的损失函数
- 从梯度的求解以及收敛上,MSE 是优于 MAE 的。MSE 处处可导,而且梯度值也是动态变化的,能够快速的收敛;而 MAE 在零点处不可导,且其梯度保持不变。对于很小的损失值其梯度也很大,在深度学习中,就需要使用变化的学习率,在损失值很小时降低学习率。
- 对离群(异常)值的处理上,MAE 要明显好于 MSE 。如果离群点(异常值)需要被检测出来,则可以选择 MSE 作为损失函数;如果离群点只是当做受损的数据处理,则可以选择 MAE 作为损失函数。
4. 损失函数的全家福
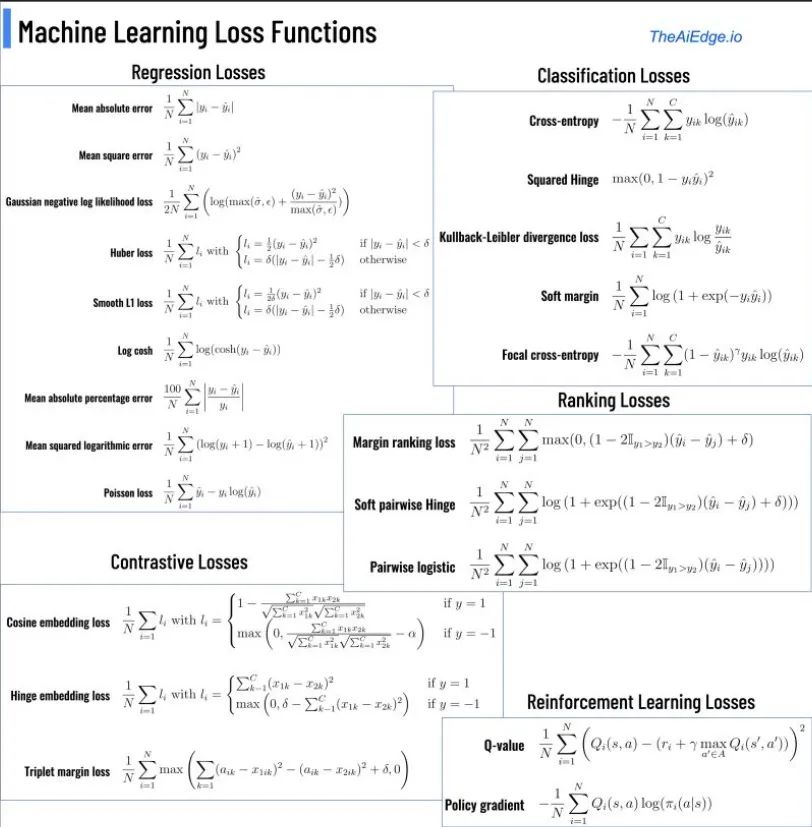
注意!此图的 Smooth L1 Loss 函数定义有错误,PyTorch 的定义应该是准确的。
参考文献
- 神经网络中的损失函数
- 一文看尽深度学习中的各种损失函数
- MSE, MAE, Huber loss详解
- 深入浅出PyTorch - 损失函数
- 交叉熵损失函数(cross-entropy loss function)原理及Pytorch代码简介
- 常见回归和分类损失函数比较
- 机器学习常用分类的损失函数
- 机器学习常用损失函数小结
- PyTorch中的CrossEntropyLoss与交叉熵计算不一致
- 分类损失函数的推导