分组加密的工作模式概述
一、背景
在密码学中,最基本的分类就是:对称加密 Vs 非对称加密。
- 如果使用相同的密钥进行消息的加密与解密(算法不一定相同,例如函数 & 逆函数),就是对称加密算法(也称为ciphers),例如:DES、3DES、AES、Blowfish、IDEA、RC5、RC6…
- 否则,就是非对称加密算法,通常需要一个密钥对:公钥 (public key) + 私钥 (private key),分别用于加密和解密,例如:RSA、DSA、ECC、DH…
关于对称加密算法,可以进一步细分为:分组加密算法 Vs 流密码算法。
- 流密码算法(Stream Cipher):明文和密钥的长度相同,按字节与密钥逐位地做约定的运算(通常是 XOR)从而获得密文流,包括 RC4 和 GSM 等
- 分组密码算法(Block Cipher):每次加密固定长度的分组(block)(例如 128 位),包括 AES、ChaCha20、Twofish、IDEA、Serpent、Camelia、RC6、CAST 等
由于分组密码的长度是固定的,但明文的长度是不确定的,由此带来了两个问题:
- 明文数据长度可能不等于分组长度的倍数,为此需要处理碎片问题,主要有填充和密文窃取两种方式,详见附录一和附录二。
- 加密或解密过程中需要多次使用同一分组密钥,如何进行密钥轮转就是工作模式的核心问题。
理论上非对称加密算法也可应用工作模式,但由于多用于密钥传输等小数据量场景,没啥价值
二、基础的工作模式
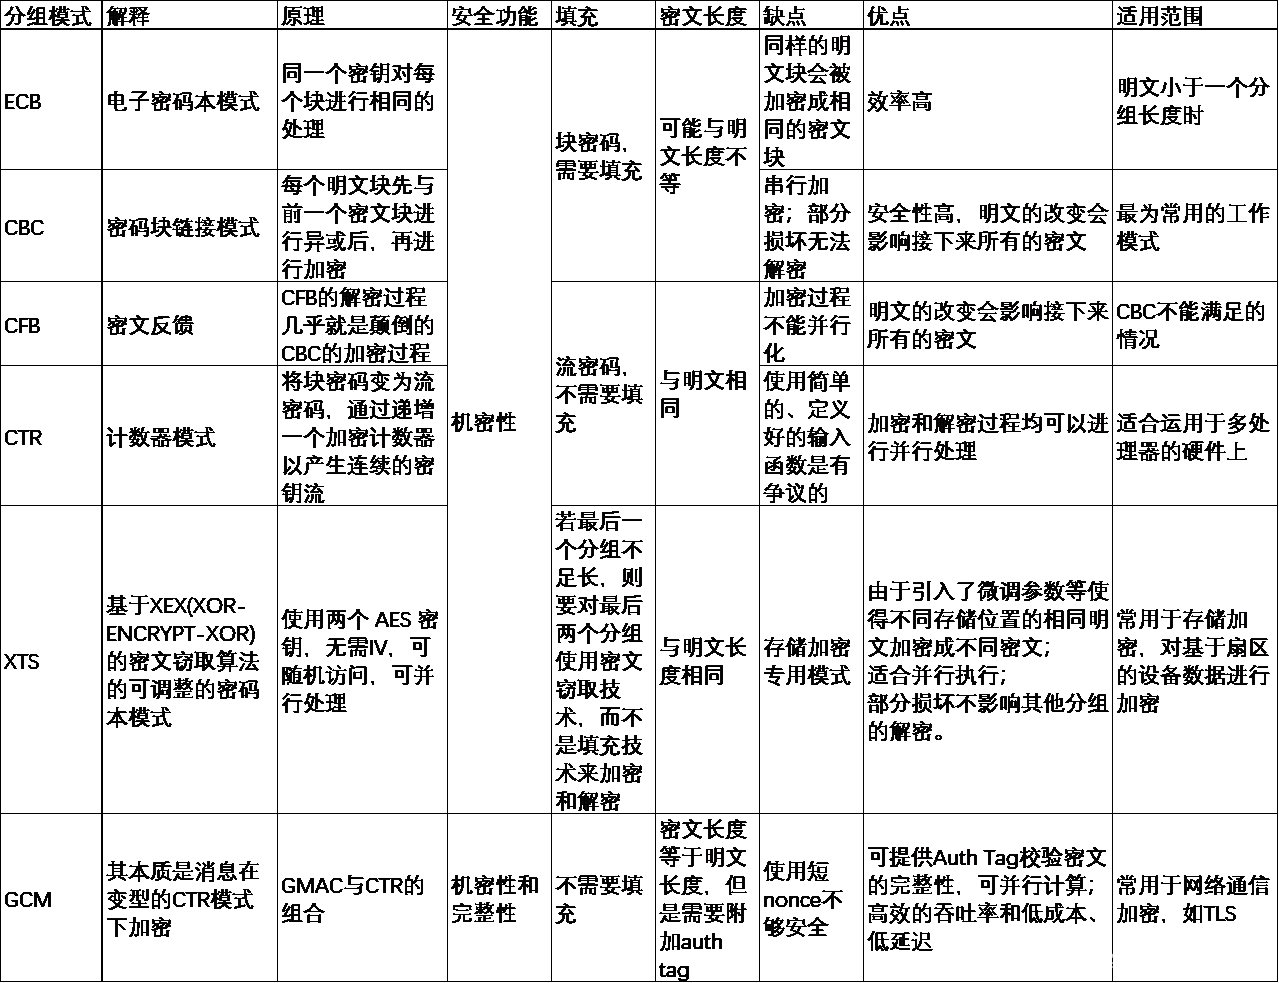
ECB,CBC,OFB 和 CFB 是最早出现的工作模式,可以追溯到1981年。
2001年,NIST 修订了SP 800-38A 标准,加入了AES,并加入了 CTR 模式。
后续, NIST 陆续补充了2份标准,后续将另文专题讨论。
- SP 800-38D,2007年发布,加入了 GCM 认证加密模式
- SP 800-38E,2010年发布,通过引用 IEEE P1619-2007 标准而加入了 XTS-AES
1、ECB 模式(Electronic codebook,电子密码本)
ECB 模式就是传统的密码本方式,将整个明文分成若干段相同的小段,然后使用同一个密钥对每一小段进行加密,非常简单明了。
$$
\begin{flalign}
ECB加密算法: & C_j=CIPH_k(P_j) &for\ j=1 \dots n \\
ECB解密算法: & P_j=CIPH_k^{-1}(C_j) &for\ j=1 \dots n
\end{flalign}
$$
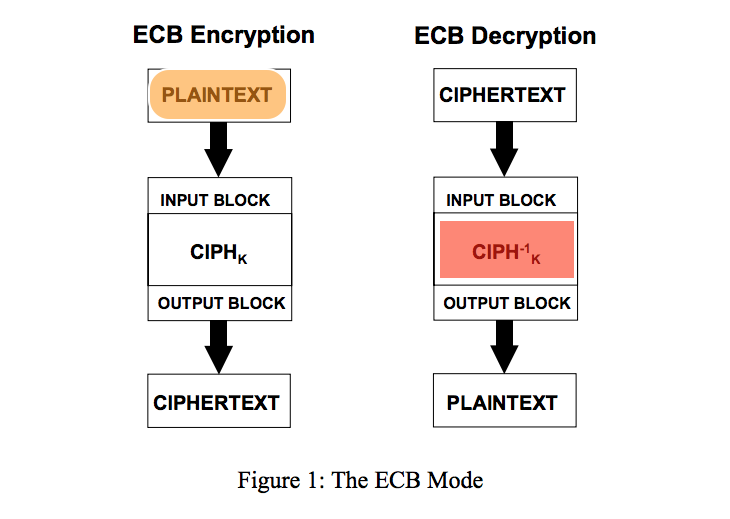
由于 ECB 模式每次分组处理采用完全相同的密钥,因此一旦某个分组的密文传输过程中出现误码,将导致当前分组的解密结果出现错误,但并不会影响其他分组,即支持加密和解密的并行处理。
ECB 模式存在严重的安全隐患,相同的明文块会被加密成相同的密文块,即著名的明文攻击问题!根本原因是用单一密钥对多个明文分组进行加密,但如果仅仅使用一个或者少量的分组(例如加密密钥传输等场景),ECB 模式仍然是安全的。下图演示了一个图像文件通过 ECB 模式的加密结果。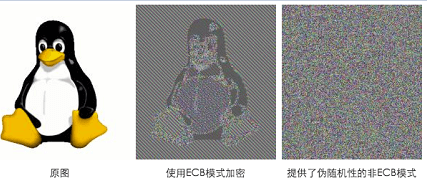
适合场景:密钥传输、文件名加密
2. CBC 模式(Cipher-block chaining,密码块链接模式)
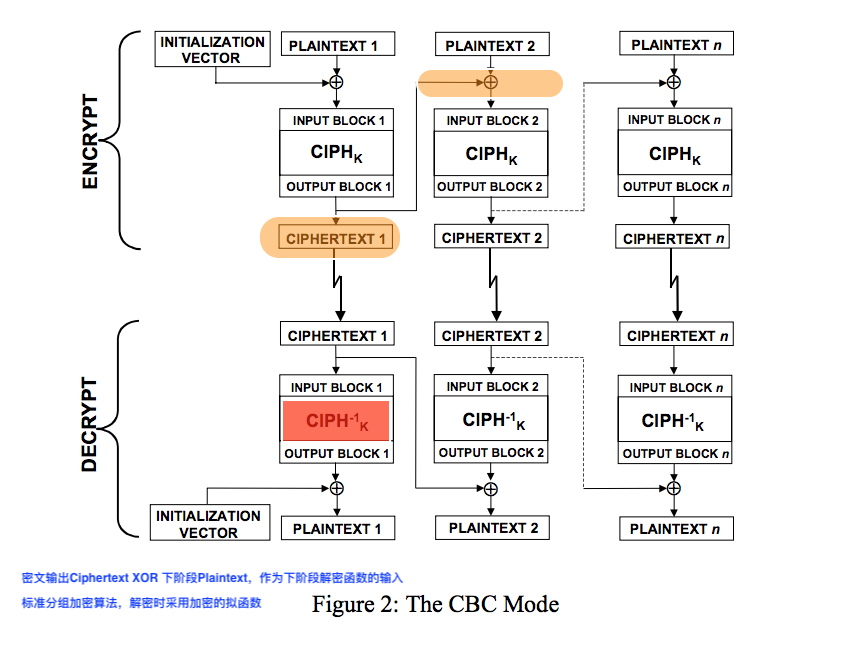
为了解决明文攻击问题,IBM 引入初始向量 IV(Initialization Vector)并提出了 CBC 模式。
$$
\begin{flalign}
CBC加密算法: & C_1 = CIPH_k(P_1 \oplus IV) \\
& C_j = CIPH_k(P_j \oplus C_{j-1}) & for\ j=2 \dots n \\
CBC解密算法: & P_1 = CIPH_k^{-1}(C_1) \oplus IV \\
& P_j = CIPH_k^{-1}(C_j) \oplus C_{j-1} & for\ j=2 \dots n \\
\end{flalign}
$$
适合场景:磁盘文件加密、面向分组的通⽤用传输、认证
3. CFB 模式(Cipher feedback,密文反馈模式)
CFB、OFB、CTR 模式的核心思想都是将初始向量 IV 转换为流密码,只是方式有所不同。
在 CBC 模式下,接收端必须收到一个完整分组后才能开始解密处理。由于 CFB 模式进行了流密码转换,因此可以在一个比分组长度更小的数据单元中进行加密。
$$
\begin{flalign}
CFB加密算法: & I_1 = IV \\
& I_j = LSB_{b-s}(I_{j-1}) | C_{j-1}^\# & for\ j=2 \dots n \\
& O_j = CIPH_k(I_j) & for\ j=1,2 \dots n \\
& C_j^\# = P^\#_j \oplus MSB_s(O_j) & for\ j=1,2 \dots n \\
\end{flalign}
$$
$$
\begin{flalign}
CFB解密算法: & I_1 = IV \\
& I_j = LSB_{b-s}(I_{j-1}) | C_{j-1}^\# & for\ j=2 \dots n \\
& O_j = CIPH_k(I_j) & for\ j=1,2 \dots n \\
& P_j^\# = C^\#_j \oplus MSB_s(O_j) & for\ j=1,2 \dots n \\
\end{flalign}
$$
- CFB 需要设定数据单元长度 s($1 <=s <= b$),通常为分组长度的因子,如1、8、64、128。每个 block 将被分为若干个长度为 s 的 segment,明文称为$P_j^\#$,密文称为$P_j^\#$
- $LSB_m(x)$:字节流x的m个低位,The bit string consisting of the m least significant bits of the bit string X.
- $MSB_m(x)$:字节流x的m个高位,The bit string consisting of the m most significant bits of the bit string X.
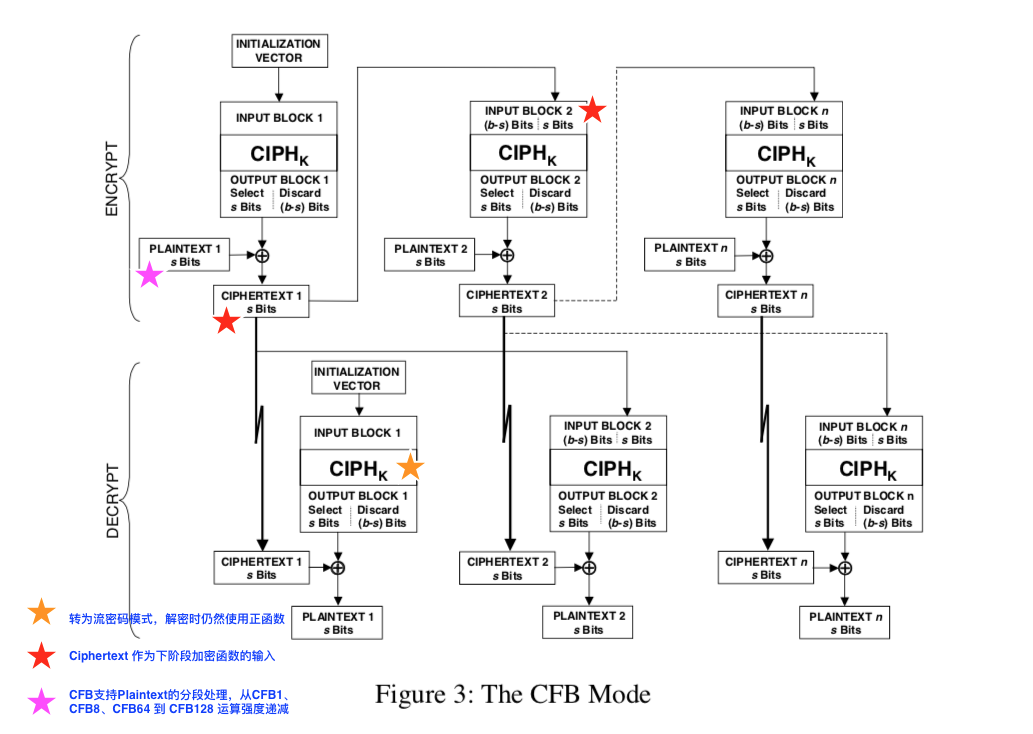
适合场景:不能容忍错误扩散的高速同步系统
4. OFB 模式(Output feedback, 输出反馈模式)
$$
\begin{flalign}
OFB加密算法: & I_1 = IV \\
& I_j = O_{j-1} & for\ j=2 \dots n \\
& O_j = CIPH_k(I_j) & for\ j=1,2 \dots n \\
& C_j = P_j \oplus O_j & for\ j=1,2 \dots n-1 \\
& C_n^\# = P_n^\# \oplus MSB_u(O_n) \\
\end{flalign}
$$
$$
\begin{flalign}
OFB解密算法: & I_1 = IV \\
& I_j = O_{j-1} & for\ j=2 \dots n \\
& O_j = CIPH_k(I_j) & for\ j=1,2 \dots n \\
& P_j = C_j \oplus O_j & for\ j=1,2 \dots n-1 \\
& P_n^\# = C_n^\# \oplus MSB_u(O_n) \\
\end{flalign}
$$
- 最后一个分组可能不完整,只有$u$位,此时将丢弃$O_j$对应的$b-u$位
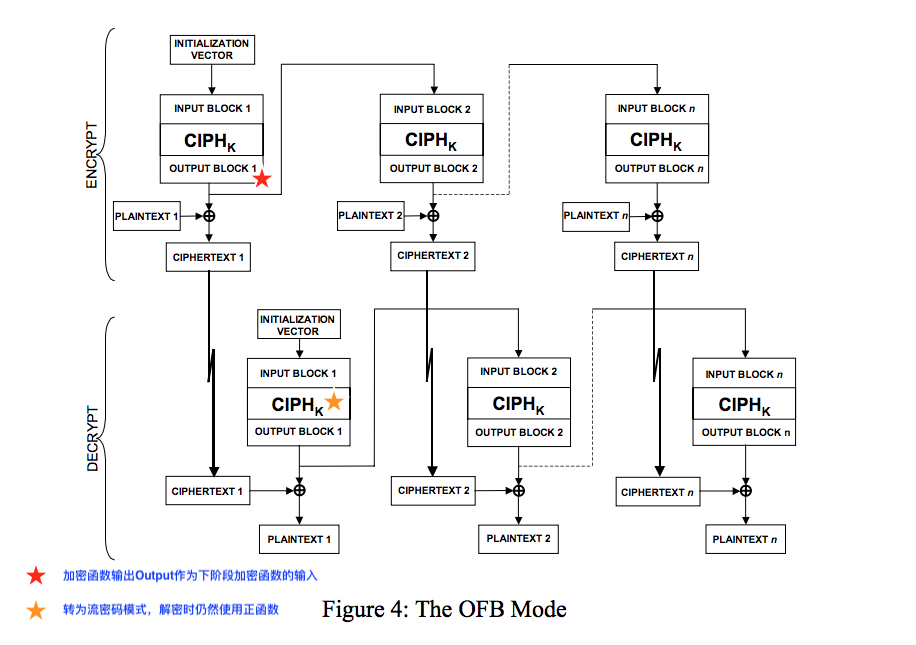
适合场景:噪声干扰严重的信道传输
5. CTR 模式(Counter,计数器模式)
CTR 模式也被称为 ICM 模式(Integer Counter Mode,整数计数模式),或者 SIC 模式(Segmented Integer Counter),不同分组流密码的随机性就是依靠计数器实现。
$$
\begin{flalign}
CTR加密算法:& O_j = CIPH_k(T_j) & for\ j=1,2 \dots n \\
& C_j = P_j \oplus O_j & for\ j=1,2 \dots n-1 \\
& C_n^\# = P_n^\# \oplus MSB_u(O_n) \\
\end{flalign}
$$
$$
\begin{flalign}
CTR解密算法:& O_j = CIPH_k(T_j) & for\ j=1,2 \dots n \\
& P_j = C_j \oplus O_j & for\ j=1,2 \dots n-1 \\
& P_n^\# = C_n^\# \oplus MSB_u(O_n) \\
\end{flalign}
$$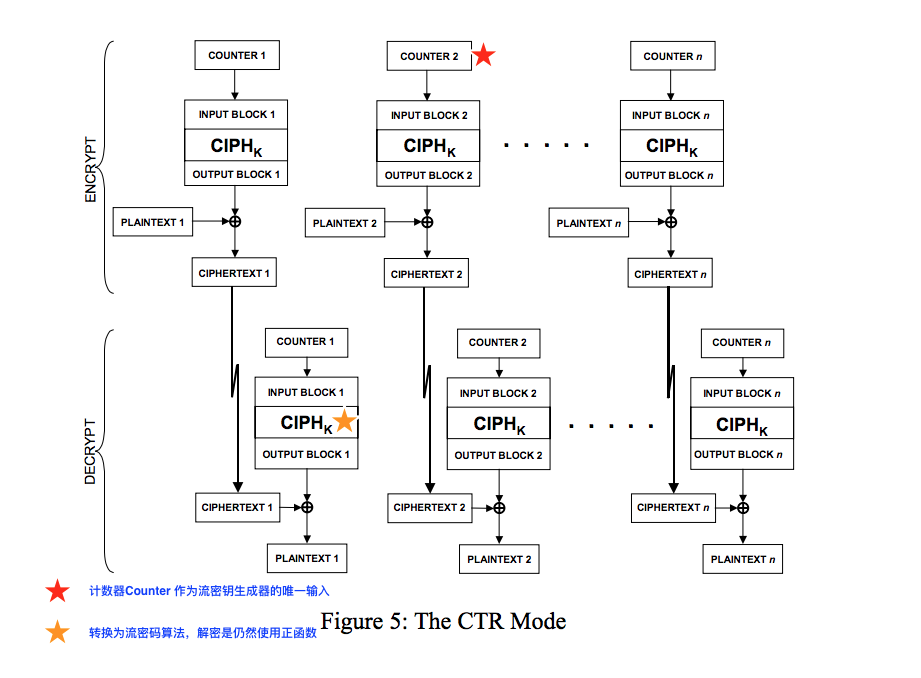
适合场景:面向分组的通⽤用传输,高速数据传输
三、技术分析
针对上述5种基本工作模式,给一个算法结构对比图,并讨论几个核心技术。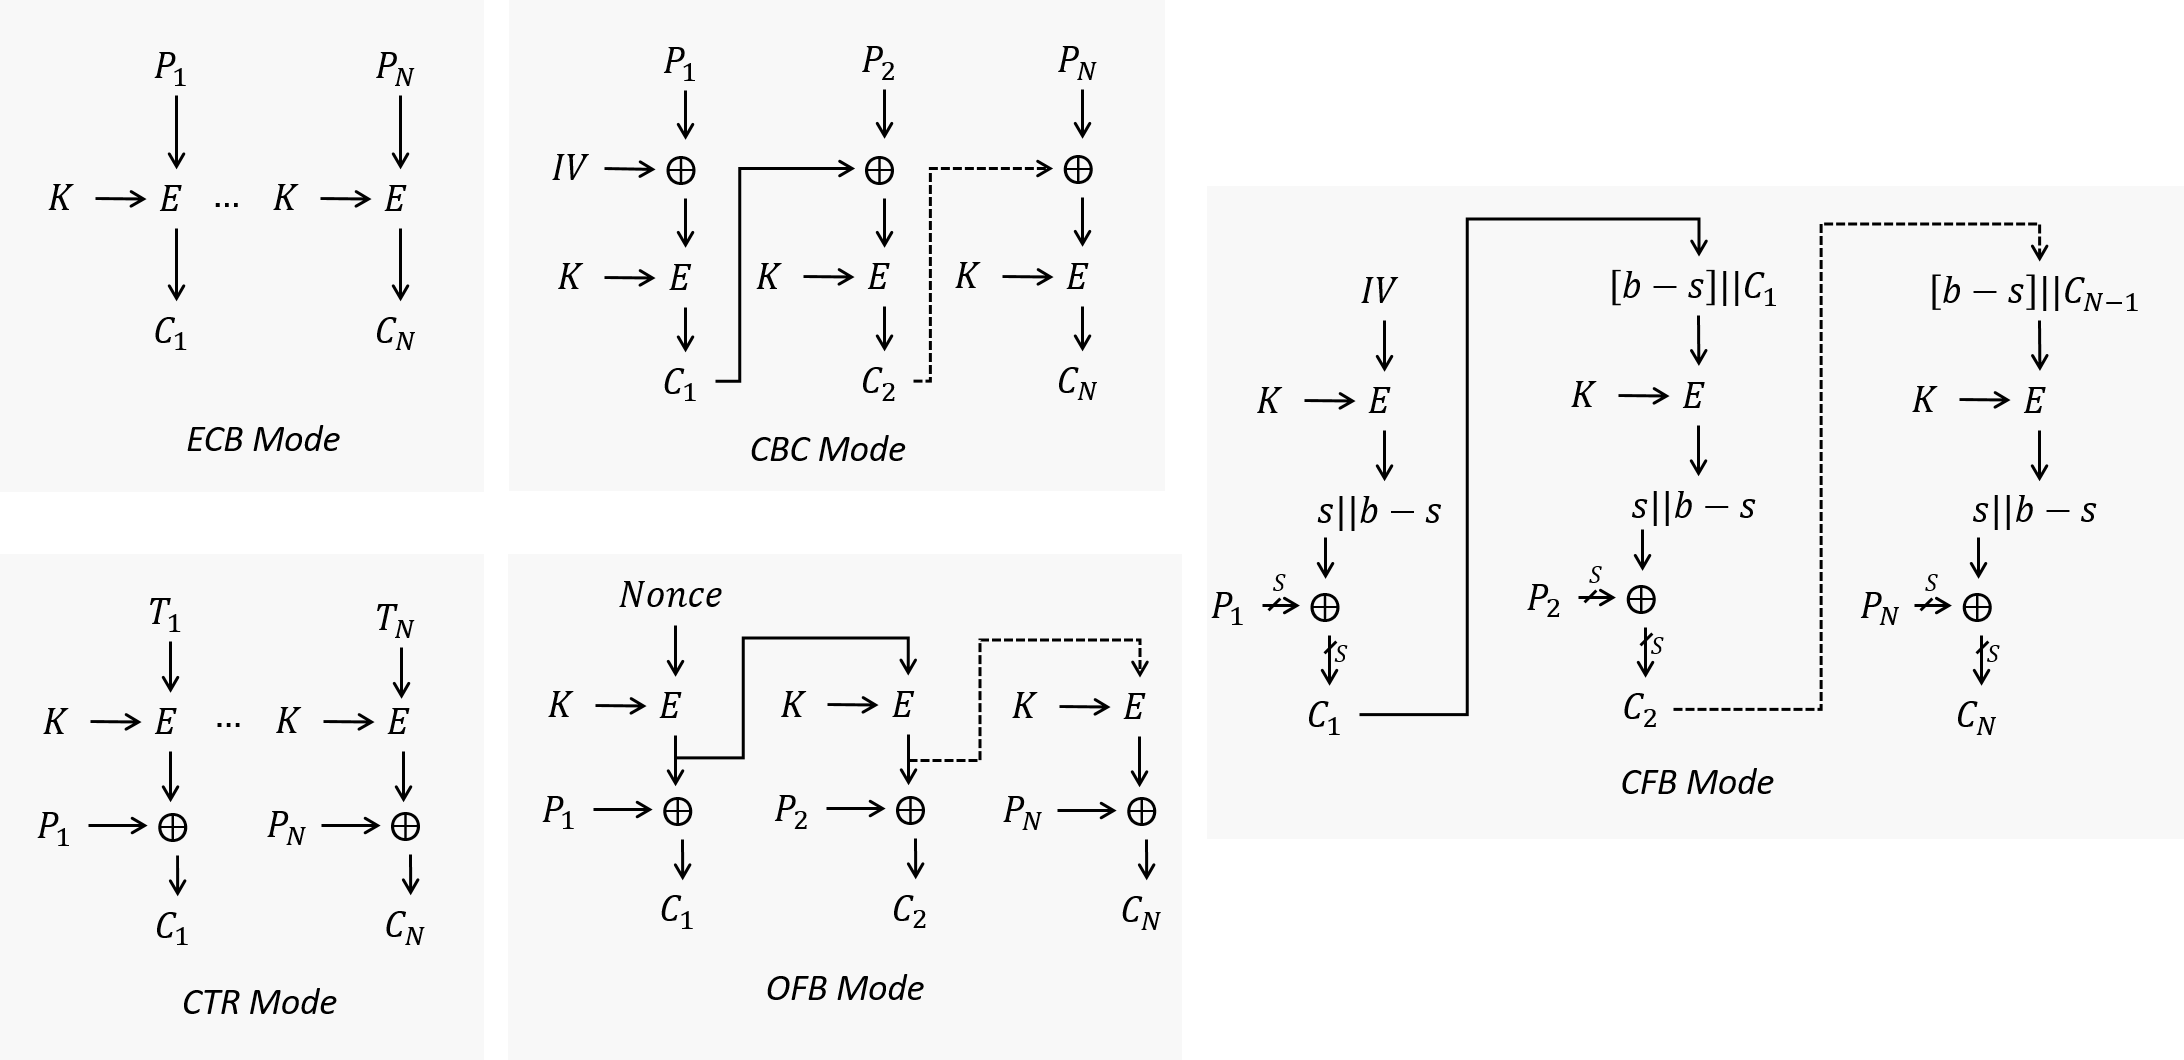
1. 流密码转换
OFB、CFB 和 CTR 的共同特征是将分组密码转化为流密码,即以初始向量作为种子,生成一个具备伪随机性的密钥流,再与明文执行 XOR 操作。
这种流密码方式的好处,一是不需要像 ECB 和 CBC 那样考虑尾部的填充问题,也不会产生明文和明文长度不一致的问题;二是加密和解密的处理流程是完全同构的,因为 XOR 操作满足互合性。
流密码有同步 / 异步 的两种工作模式,即:
同步序列密码 - synchronous stream cipher
军方称密钥自动密钥(KAK,Key Auto-Key),密钥流的生成独立于消息序列,不依赖于任何先前的明文或密文。
- 同步错误不可恢复:KAK 必须保持加密端和解密端的完全同步,如果其中一个发生器跳过一个周期,或者一个密文位在传输过程中丢失,那么错误后面的每一个密文都不能正确解密。
- 无错误扩散:说如果一位在传输过程中被改变,那么只有该位不能正确解密,前面和后面的位都不受影响。
- 需要注意的是,KAK 实现依靠有限状态的机器实现,密钥序列一定会重复,为了抵御明文攻击,发生器的周期必须非常长,至少不能小于明文的长度。
OFB 和 CTR 模式都属于 KAK。目前常见的大多数流密码算法都是同步流密码。
自同步流密码 - self-synchronizing stream ciper
也称异步流密码。军方称之为密文自动密钥(Cipher Text Auto Key,CTAK),密钥流的生成必须依赖于前面固定长度的密文位。
- 同步错误可恢复:传输过程中如果密文字被插入或者删除,导致同步性遭到破坏后,经过固定长度后可以自动地重建正确的解密,而且仅有固定数量的明文字不可恢。
- 有限的错误扩散:即如果传输中一个密文位被篡改,解密端该分组将有 s 个序列位不能正确解密,直到内部状态不在包含该错误位。
- 明文统计扩散:每个明文字都会影响其后的整个密文,即明文的统计学特征被扩散(稀释)到了密文中,因此在抵抗利用明文冗余度而发起的攻击方面要强于同步流密码。
CFB 模式属于 CTAK。
2. 并行处理
如果算法支持并行处理,硬件实现可以多个硬件块同时处理,软件实现也可以有效利用多CPU核心,对性能非常有利。
ECB 的加密和解密都支持并行,但由于存在明文攻击,只适用于少量数据的处理,因此没啥意义。
CBC 和 CFB 的特性相同,即加密过程不支持并行,但解密过程可以并行。
加密时,由于存在初始变量 IV,而且采用反馈模式增加了各个分组之间的联系,因此不支持并行。
解密时,从两个邻接的密文块中即可得到一个明文块,因此可以并行化。
CBC 可以支持随机读取,因为没有流密码的转换,只需要掌握前后两个密文块
OFB 的情况有点特殊!其加密和解密中,每个正向加密函数(第一个除外)取决于之前正向加密函数的结果,因此理论上都不能并行化。
然而,在掌握 IV 的前提下,在获得明文或密文数据之前,可以通过预处理提前生成密钥流,就可以支持并行处理了。实际应用中,经常利用 CBC 硬件块输入全0,能够很方便的产生 OFB 密钥流。
CTR 具备最优秀的并行性,加密和解密都可以,而且允许在解密时进行随机存取(只依赖计数器,无需预处理),因此非常适合多处理器的硬件实现。
3. 初始向量
初始化向量(IV,Initialization Vector)为加密计算提供了新的随机性,即可以有效抵御明文攻击,又避免了较慢的重新产生密钥的过程。
初始化向量与密钥相比有不同的安全性需求,通常情况下 IV 无须保密,然而在大多数情况中,不应当在使用同一密钥的情况下两次使用同一个 IV。
- CBC、CFB:重用IV会导致泄露明文首个块的某些信息,亦包括两个不同消息中相同的前缀。
- OFB、CTR:重用IV会导致完全失去安全性。
- 此外,在 CBC 模式中,IV 在加密时必须是无法预测的;
- 特别的,在许多实现中使用的产生IV的方法,例如 SSL2.0 采用上一个消息的最后一块密文作为下一个消息的IV,是不安全的。
4. 分组密码的填充问题
在分组密码中,当数据长度不等于分组长度的倍数时,需要按一定的方式,将尾部明文分组进行填充,这种将尾部分组数据填满的方法称为填充(Padding)。
例如 CBC 模式应使用填充算法使最后一个分组的长度一致。大多数应用程序使用 PKCS#7 或 ANSI X.923。
采用填充方式时,密文长度通常大于明文长度,意味着网络传输时需要消耗额外的传输能力。
ANSI X9.23
在填充字节序列中,最后一个字节填充为需要填充的字节长度(示例为0x04),其余字节填充0。... | DD DD DD DD DD DD DD DD | DD DD DD DD 00 00 00 04 |
PKCS#7
PKCS#7 定义于 RFC 5652。在填充字节序列中,每个字节填充为需要填充的字节长度(示例为0x04)。... | DD DD DD DD DD DD DD DD | DD DD DD DD 04 04 04 04 |
ISO 10126
在填充字节序列中,最后一个字节填充为需要填充的字节长度(示例为0x04),其余字节填充随机数。... | DD DD DD DD DD DD DD DD | DD DD DD DD 81 A6 23 04 |
ISO/IEC 7816-4
在填充字节序列中,第一个字节填充固定值0x80,其余字节填充0。若只需填充一个字节,则直接填充0x80。... | DD DD DD DD DD DD DD DD | DD DD DD DD 80 00 00 00 |... | DD DD DD DD DD DD DD DD | DD DD DD DD DD DD DD 80 |
5. 密文窃取
窃取密文(Ciphertext stealing)通过修改消息的最后两块,以实现密文与明文大小相同的目标。
加密时,除了最后两块之外,所有块都正常处理,但“窃取”倒数第二块的一部分密文用以填充最后一块明文块。填充的最后一块,然后像往常一样加密。最终密文的最后两块,包括部分倒数第二块(删掉“窃取”部分)和完整的最后一块,它们大小与原明文相同。
解密时,首先解密最后一块,然后将“窃取”的密文恢复到倒数第二块,然后可以像往常一样解密。
原则上,任何使用块密码的分组加密模式都可用,但流密码模式已经可以加密任意长度的消息无需填充,因此它们不能用该操作。与窃取密文相结合的常用加密方式有电子密码本(ECB)和密码块链接(CBC)。
ECB 密文窃取要求明文长度大于一个分组。当明文长度为一个或更少时,建议使用一种类似流密码的分组密码操作模式,如 CTR、CFB 或 OFB。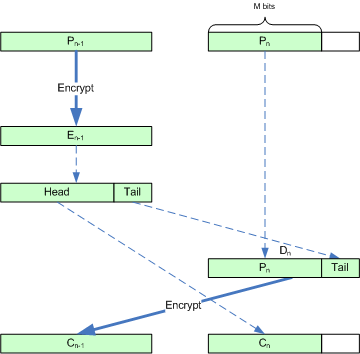
CBC 密文窃取并不一定要求明文长度大于一个分组。在明文为一块或更少块长度的情况下,初始向量(IV)可作为先前的密文块。在这种情况,必须将修改后的IV发送予接受者。但这在发送密文时 IV 不能由发送者自由选择的情况下(如当 IV 是派生值或预先确定的值)不太可能,并且在这种情况下,针对 CBC 模式的密文窃取只能在明文长于一个块文中发生。
采用密文窃取方式时,密文长度严格等于明文长度,不会浪费网络传输能力,同时这个优点非常适合磁盘文件存储(文件大小等于密文长度),因此产生 AES-XTS 工作模式。
为了以 AES-XTS 加密或解密未知长度的数据,必须延迟处理(和缓存)最新的两块数据块,以便处理数据流末端。
四、不完整的总结